

Предварительные требования
Прежде чем продолжить, убедитесь, что у вас есть базовое представление о конвейере знаний и некоторые знания о разработке плагинов. Соответствующую информацию можно найти здесь:Типы плагинов источников данных
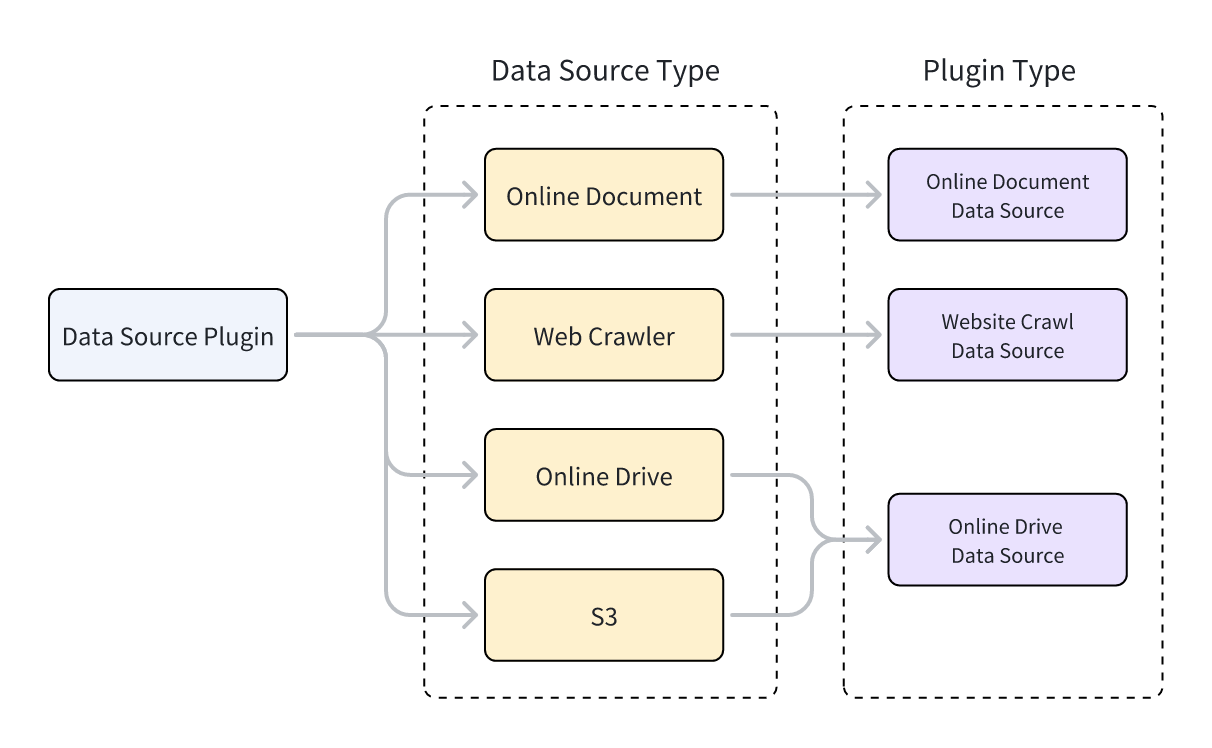
Интеллос поддерживает три типа плагинов источников данных: веб-краулер, онлайн-документ и онлайн-диск. При реализации кода плагина класс, который предоставляет функциональность плагина, должен наследоваться от определённого класса источника данных. Каждому из трёх типов плагинов соответствует свой родительский класс.О том, как наследоваться от родительского класса для реализации функциональности плагина, см. Плагин-инструмент: подготовка кода инструмента.
- Веб-краулер: Jina Reader, FireCrawl
- Онлайн-документ: Notion, Confluence, GitHub
- Онлайн-диск: OneDrive, Google Drive, Box, AWS S3, Tencent COS
Разработка плагина источника данных
Создание плагина источника данных
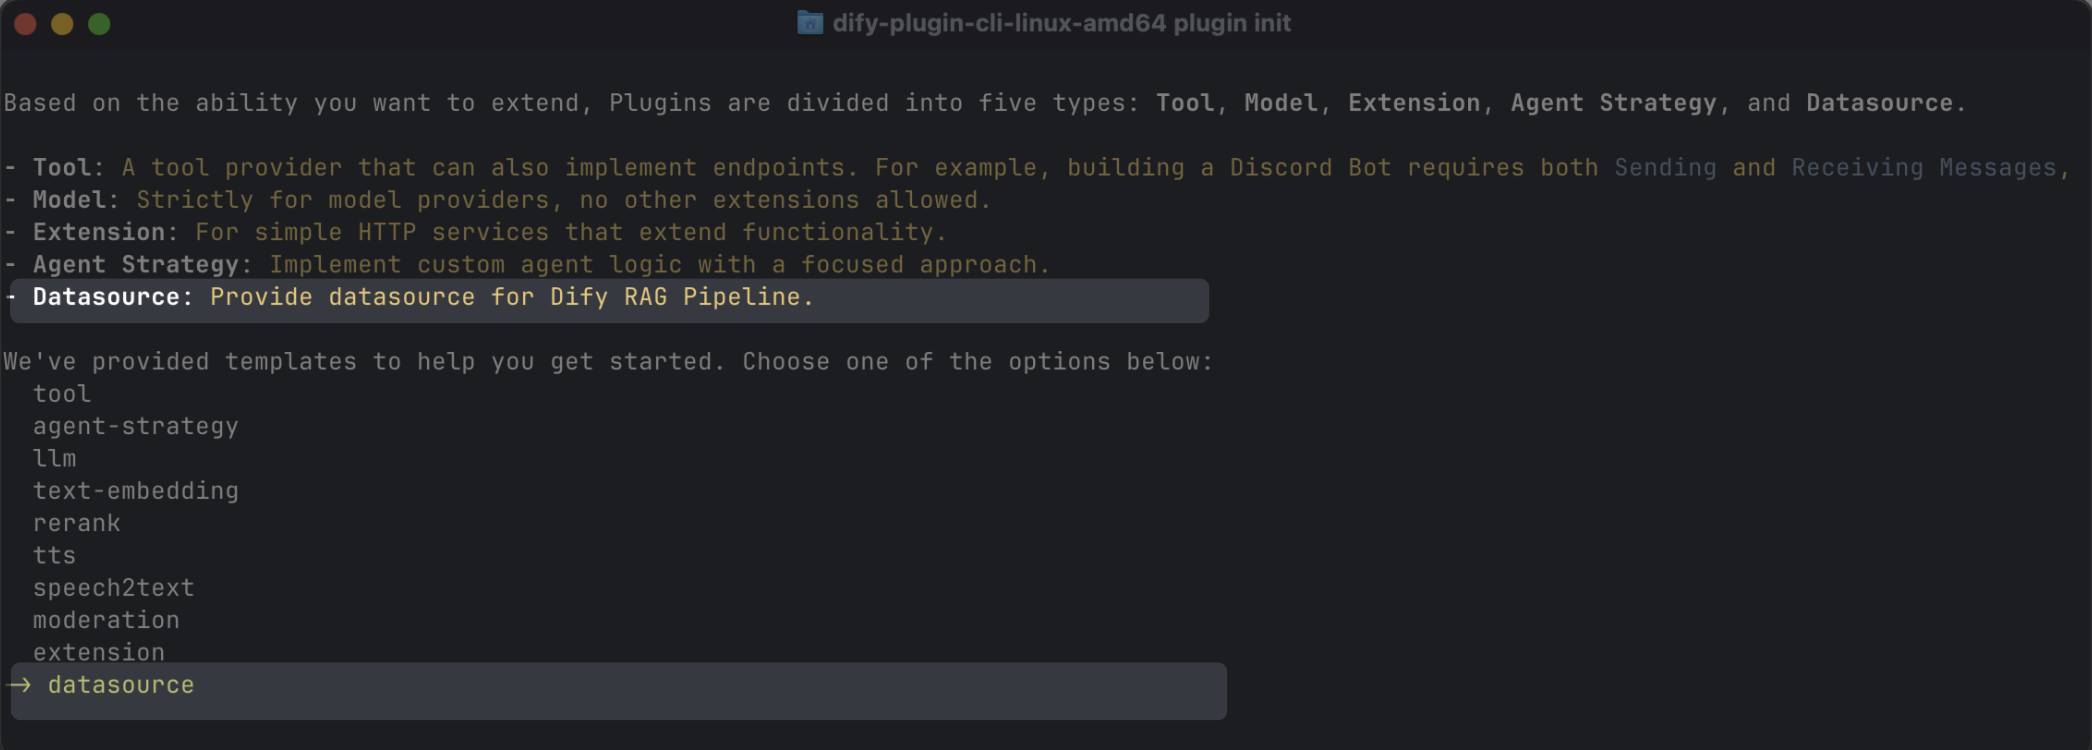
Чтобы создать плагин источника данных, можно воспользоваться командной строкой инструмента-каркаса, выбрав типdatasource. После завершения настройки командная строка автоматически сгенерирует код проекта плагина.
Как правило, плагину источника данных не требуется использовать другие возможности платформы Интеллос, поэтому дополнительные разрешения не нужны.
Структура плагина источника данных
Плагин источника данных состоит из трёх основных компонентов:- Файл
manifest.yaml: описывает основную информацию о плагине. - Каталог
provider: содержит описание поставщика плагина и код реализации аутентификации. - Каталог
datasources: содержит описание и основную логику получения данных из источника данных.
Установка правильной версии и тега
-
В файле
manifest.yamlзадайте минимальную поддерживаемую версию Интеллос следующим образом: -
В файле
manifest.yamlдобавьте следующий тег, чтобы плагин отображался в категории источников данных в Интеллос Маркетплейс: -
В файле
requirements.txtзадайте версию SDK плагина, используемую для разработки плагина источника данных, следующим образом:
Добавление поставщика источника данных
Создание YAML-файла поставщика
Содержимое YAML-файла поставщика по сути такое же, как и для плагинов-инструментов, со следующими двумя отличиями:Подробнее о создании YAML-файла поставщика см. Плагин-инструмент: заполнение учётных данных стороннего сервиса.
Плагины источников данных поддерживают аутентификацию через OAuth 2.0 или API Key.О настройке OAuth см. Добавление поддержки OAuth в ваш плагин-инструмент.
Создание файла кода поставщика
-
При использовании режима аутентификации по API Key файл кода поставщика для плагинов источников данных идентичен файлу для плагинов-инструментов. Нужно лишь изменить родительский класс, наследуемый классом поставщика, на
DatasourceProvider. -
При использовании режима аутентификации OAuth плагины источников данных немного отличаются от плагинов-инструментов. При получении прав доступа через OAuth плагины источников данных могут одновременно возвращать имя пользователя и аватар для отображения на фронтенде. Поэтому методы
_oauth_get_credentialsи_oauth_refresh_credentialsдолжны возвращать типDatasourceOAuthCredentials, который содержитname,avatar_url,expires_atиcredentials. КлассDatasourceOAuthCredentialsопределён следующим образом и при возврате должен быть приведён к соответствующему типу:
_oauth_get_authorization_url, _oauth_get_credentials и _oauth_refresh_credentials выглядят следующим образом:
- _oauth_get_credentials
- _oauth_refresh_credentials
Добавление источника данных
Формат YAML-файла и формат кода источника данных различаются для трёх типов источников данных.Веб-краулер
В YAML-файле поставщика для плагина-веб-краулера источника данныхoutput_schema всегда должен возвращать четыре параметра: source_url, content, title и description.
WebsiteCrawlDatasource и реализовывать метод _get_website_crawl. Затем для возврата сообщения о результатах сканирования используется метод create_crawl_message.
Чтобы просканировать несколько веб-страниц и возвращать их пакетами, можно задать WebSiteInfo.status значение processing и использовать метод create_crawl_message для возврата каждого пакета просканированных страниц. После сканирования всех страниц задайте WebSiteInfo.status значение completed.
Онлайн-документ
Возвращаемое значение для плагина-онлайн-документа источника данных должно содержать как минимум полеcontent, представляющее содержимое документа. Например:
OnlineDocumentDatasource и реализовывать два метода: _get_pages и _get_content.
Когда пользователь запускает плагин, тот сначала вызывает метод _get_pages для получения списка документов. После того как пользователь выбирает документ из списка, плагин вызывает метод _get_content для получения содержимого документа.
- _get_pages
- _get_content
Онлайн-диск
Плагин-онлайн-диск источника данных возвращает файл, поэтому он должен соответствовать следующей спецификации:OnlineDriveDatasource и реализовывать два метода: _browse_files и _download_file.
Когда пользователь запускает плагин, тот сначала вызывает _browse_files для получения списка файлов. На этом этапе prefix пуст, что означает запрос списка файлов корневого каталога. Список файлов содержит переменные как типа «папка», так и типа «файл». Если пользователь открывает папку, метод _browse_files вызывается снова. На этом этапе prefix в OnlineDriveBrowseFilesRequest будет идентификатором папки, который используется для получения списка файлов внутри этой папки.
После того как пользователь выбирает файл, плагин использует метод _download_file и идентификатор файла для получения содержимого файла. С помощью метода _get_mime_type_from_filename можно получить MIME-тип файла, что позволяет конвейеру корректно обрабатывать файлы разных типов.
Когда список файлов содержит несколько файлов, можно задать OnlineDriveFileBucket.is_truncated значение True и задать OnlineDriveFileBucket.next_page_parameters параметры, необходимые для получения следующей страницы списка файлов, например идентификатор или URL запроса следующей страницы — в зависимости от поставщика сервиса.
- _browse_files
- _download_file
prefix, bucket и id имеют особое назначение и могут гибко применяться по необходимости в ходе разработки:
prefix: представляет префикс пути к файлу. Например,prefix=container1/folder1/извлекает файлы или список файлов из папкиfolder1в бакетеcontainer1.bucket: представляет файловый бакет. Например,bucket=container1извлекает файлы или список файлов в бакетеcontainer1. Это поле можно оставить пустым для дисков с нестандартным протоколом S3.id: поскольку метод_download_fileне использует переменнуюprefix, полный путь к файлу должен быть включён вid. Например,id=container1/folder1/file1.txtозначает извлечение файлаfile1.txtиз папкиfolder1в бакетеcontainer1.
Отладка плагина
Плагины источников данных поддерживают два метода отладки: удалённую отладку или установку как локального плагина для отладки. Обратите внимание на следующее:- Если плагин использует аутентификацию OAuth,
redirect_uriдля удалённой отладки отличается от такового для локального плагина. Обновите соответствующую конфигурацию в OAuth-приложении вашего поставщика сервиса. - Хотя плагины источников данных поддерживают пошаговую отладку, мы всё же рекомендуем тестировать их в полном конвейере знаний, чтобы убедиться в полной работоспособности.
Финальные проверки
Перед упаковкой и публикацией убедитесь, что вы выполнили всё перечисленное ниже:- Задали минимальную поддерживаемую версию Интеллос как
1.9.0. - Задали версию SDK как
dify-plugin>=0.5.0,<0.6.0. - Написали файлы
README.mdиPRIVACY.md. - Включили в файлы кода только англоязычный контент.
- Заменили иконку по умолчанию на логотип поставщика источника данных.
Упаковка и публикация
В каталоге плагина выполните следующую команду, чтобы сгенерировать пакет плагина.difypkg:
- Импортировать и использовать плагин в вашей среде Интеллос.
- Опубликовать плагин в Интеллос Маркетплейс, отправив pull request.
О процессе публикации плагинов см. Публикация плагинов.
Edit this page | Report an issue