

Выбор метода индексации
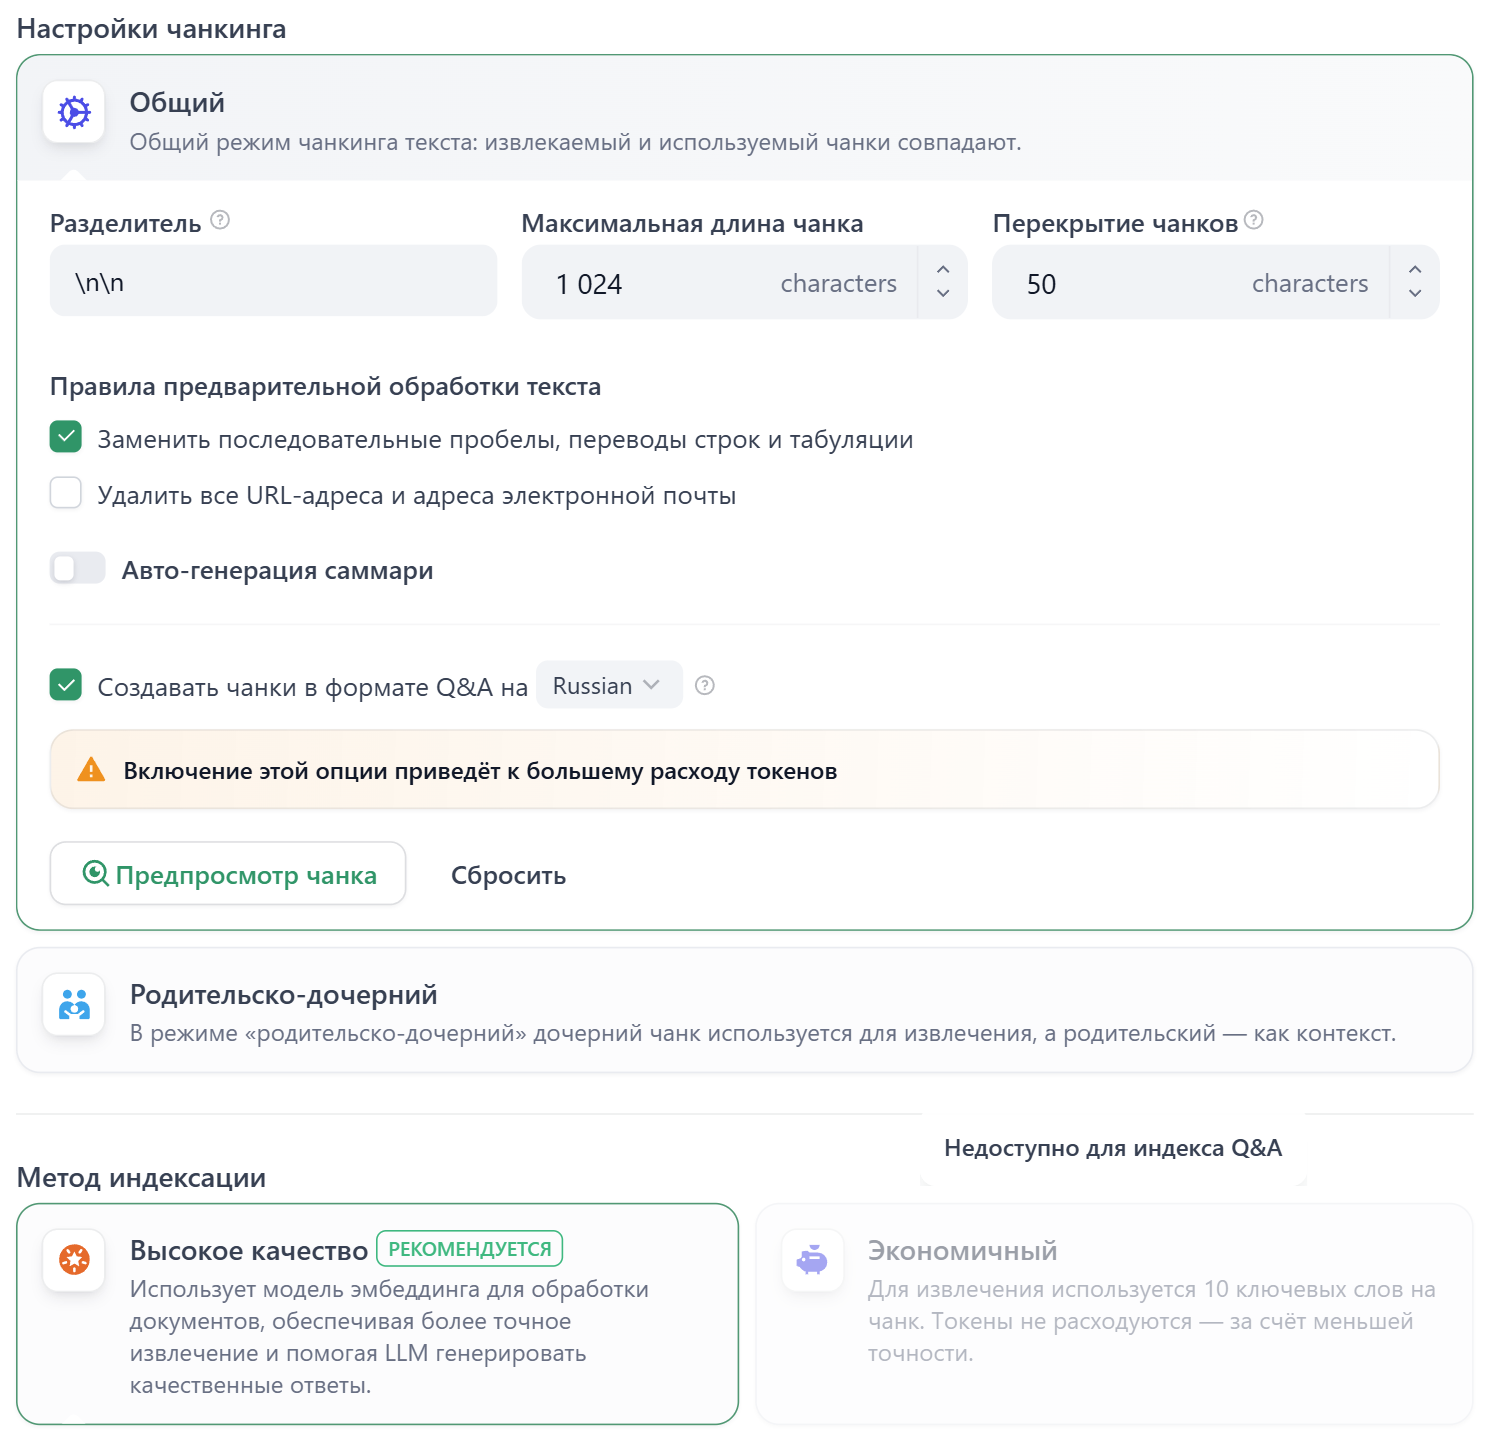
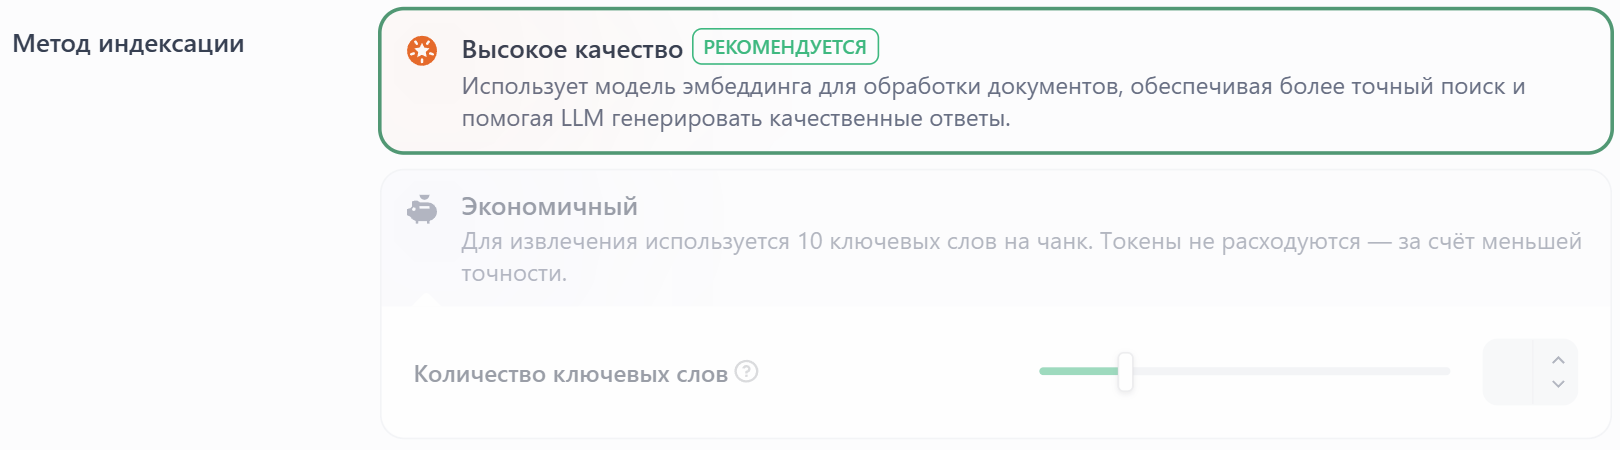
Подобно тому как поисковые системы используют эффективные алгоритмы индексации для подбора результатов, наиболее релевантных запросам пользователя, выбранный метод индексации напрямую влияет на эффективность поиска LLM и на точность её ответов по содержимому базы знаний. База знаний предлагает два метода индексации: Высокое качество и Экономичный, у каждого из которых свой набор настроек поиска.- Высокое качество
- Экономичный
Если база знаний создана с методом индексации «Высокое качество», переключить её на «Экономичный» впоследствии нельзя.
Чтобы включить кросс-модальный поиск — извлечение и текста, и изображений по семантической релевантности, — выберите мультимодальную эмбеддинг-модель (отмеченную значком Распознавание изображений). Изображения, извлечённые из документов, будут эмбеддированы и проиндексированы для поиска.Базы знаний, использующие такие эмбеддинг-модели, помечаются на карточках как Мультимодальный.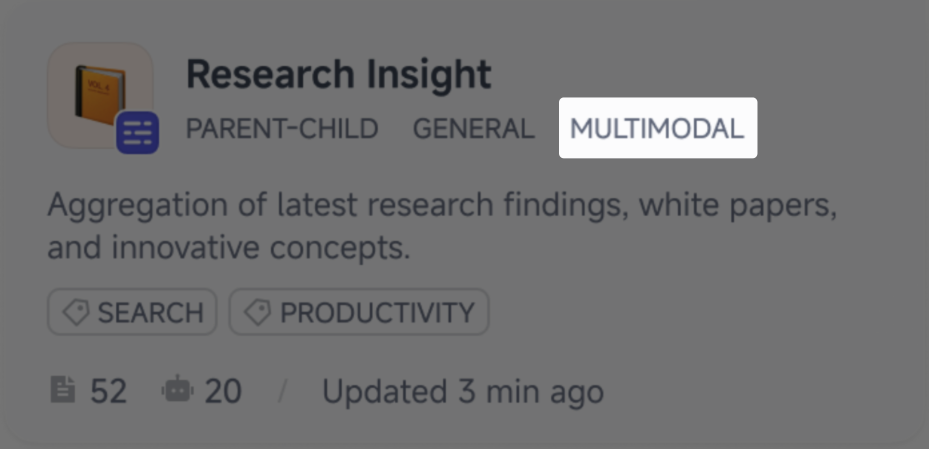
Режим Вопрос-ответ
Режим Вопрос-ответ доступен только в самостоятельно размещённых развёртываниях.
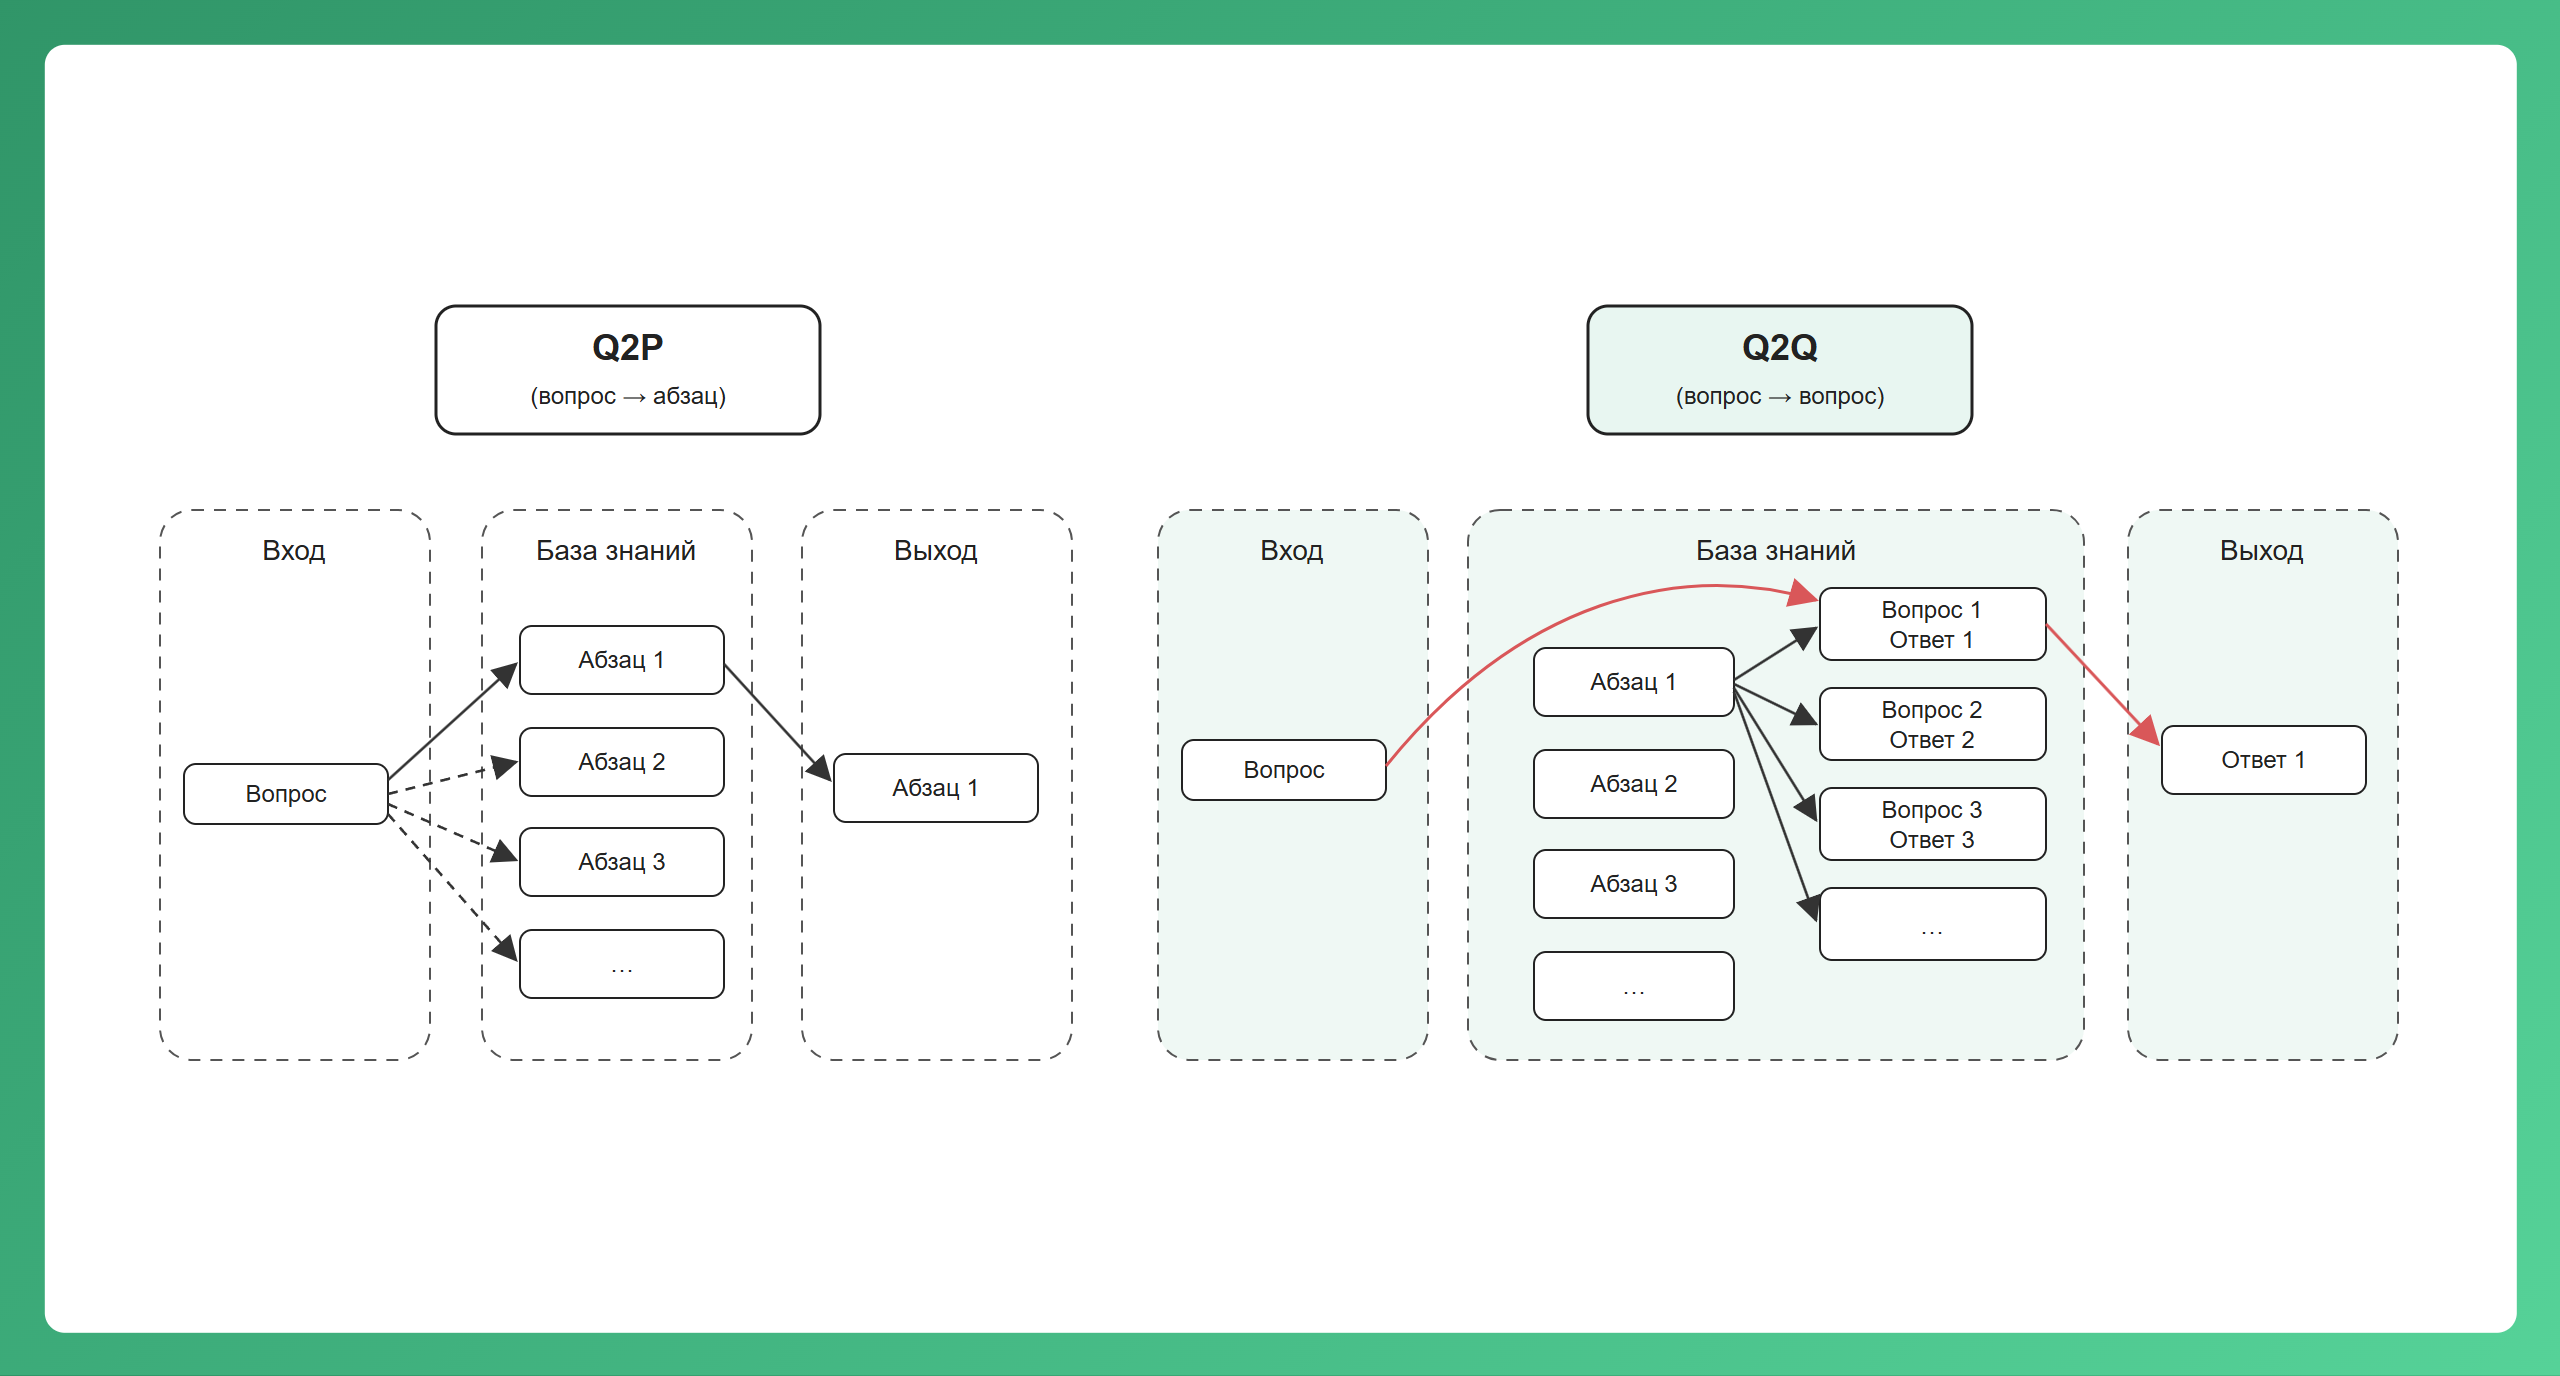
Стратегия Q to Q делает сопоставление между вопросами и ответами более чётким и лучше подходит для сценариев с частыми или очень похожими вопросами.
Настройка параметров поиска
Получив запрос пользователя, база знаний ищет по имеющимся документам в соответствии с заданными методами поиска и извлекает высокорелевантные чанки контента. Эти чанки дают LLM необходимый контекст и в итоге влияют на точность и достоверность её ответов. К распространённым методам поиска относятся:- Семантический поиск на основе векторной близости — текстовые чанки и запросы преобразуются в векторы и сопоставляются по оценке сходства.
- Сопоставление по ключевым словам с использованием инвертированного индекса (стандартная технология поисковых систем). Оба метода поддерживаются в базе знаний Интеллос.
- Высокое качество
- Экономичный
Высокое качествоПри методе индексации Высокое качество Интеллос предлагает три настройки поиска: Векторный поиск, Полнотекстовый поиск и Гибридный поиск.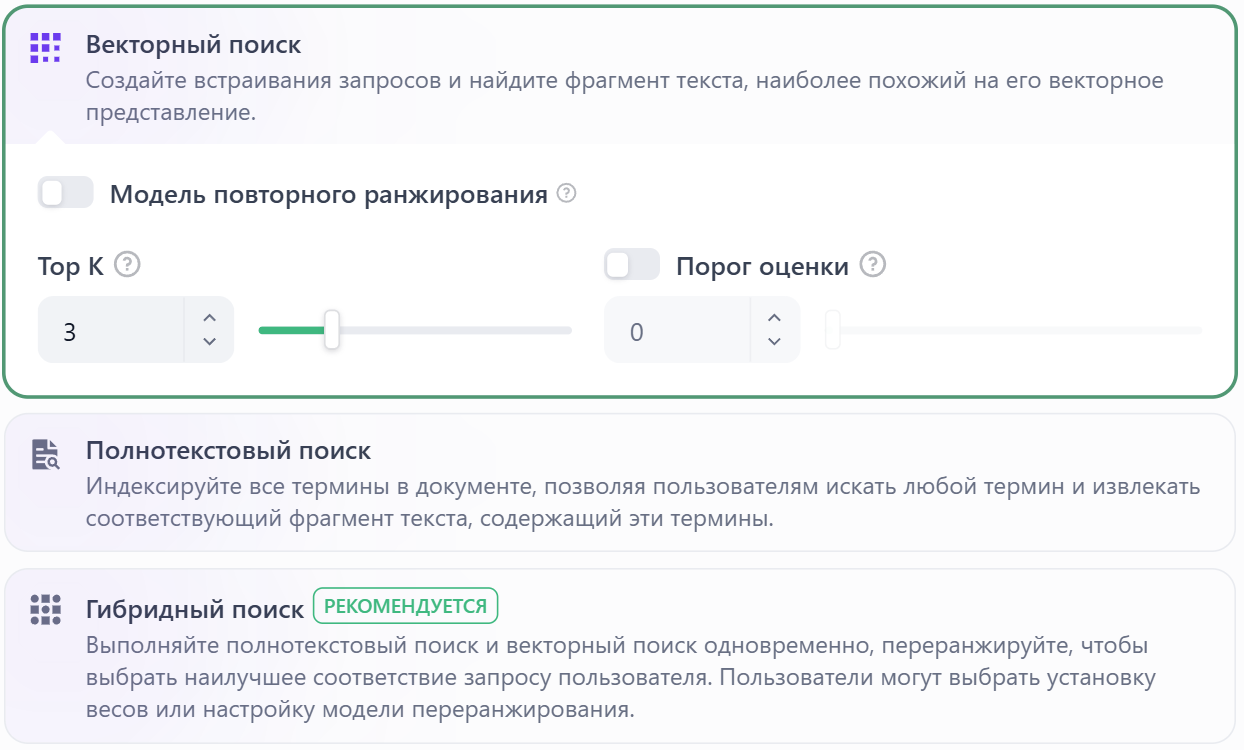 Векторный поискОпределение: векторизует вопрос пользователя, формируя вектор запроса, а затем сравнивает его с соответствующими векторами текста в базе знаний, чтобы найти ближайшие чанки.
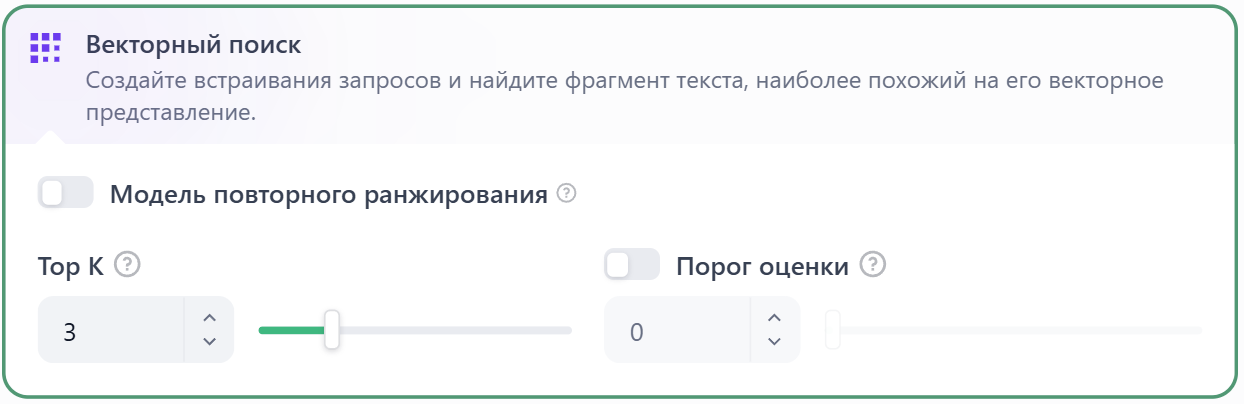 Настройки векторного поиска:Модель повторного ранжирования: отключена по умолчанию. Когда она включена, сторонняя реранк-модель сортирует чанки текста, возвращённые векторным поиском, чтобы оптимизировать результаты. Это помогает LLM получить более точную информацию и повысить качество вывода. Прежде чем включать этот параметр, перейдите в Настройки → Поставщик модели и настройте API Key реранк-модели.
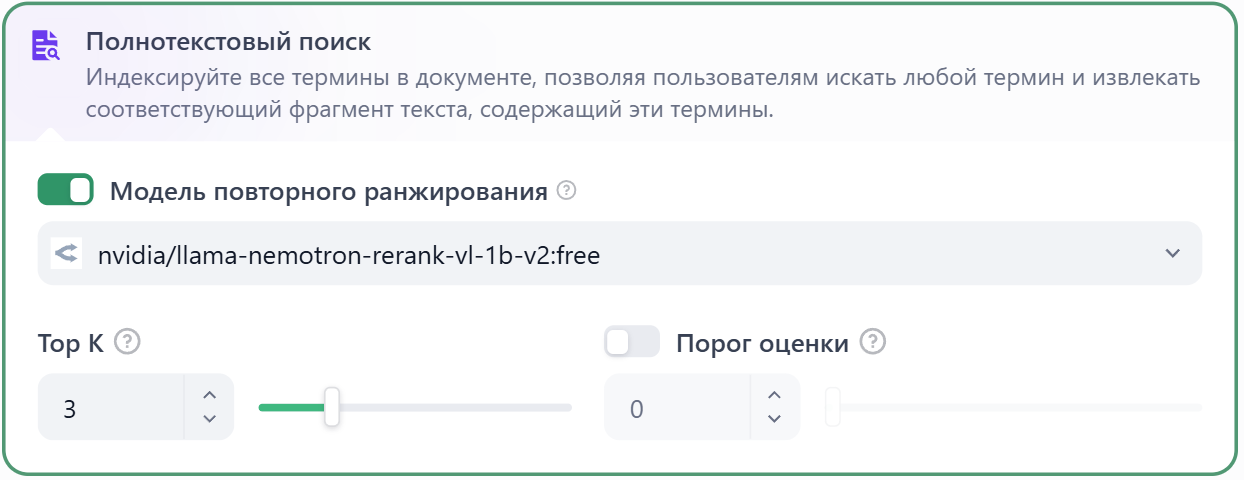 Модель повторного ранжирования: отключена по умолчанию. Когда она включена, сторонняя реранк-модель сортирует чанки текста, возвращённые полнотекстовым поиском, чтобы оптимизировать результаты. Это помогает LLM получить более точную информацию и повысить качество вывода. Прежде чем включать этот параметр, перейдите в Настройки → Поставщик модели и настройте API Key реранк-модели.
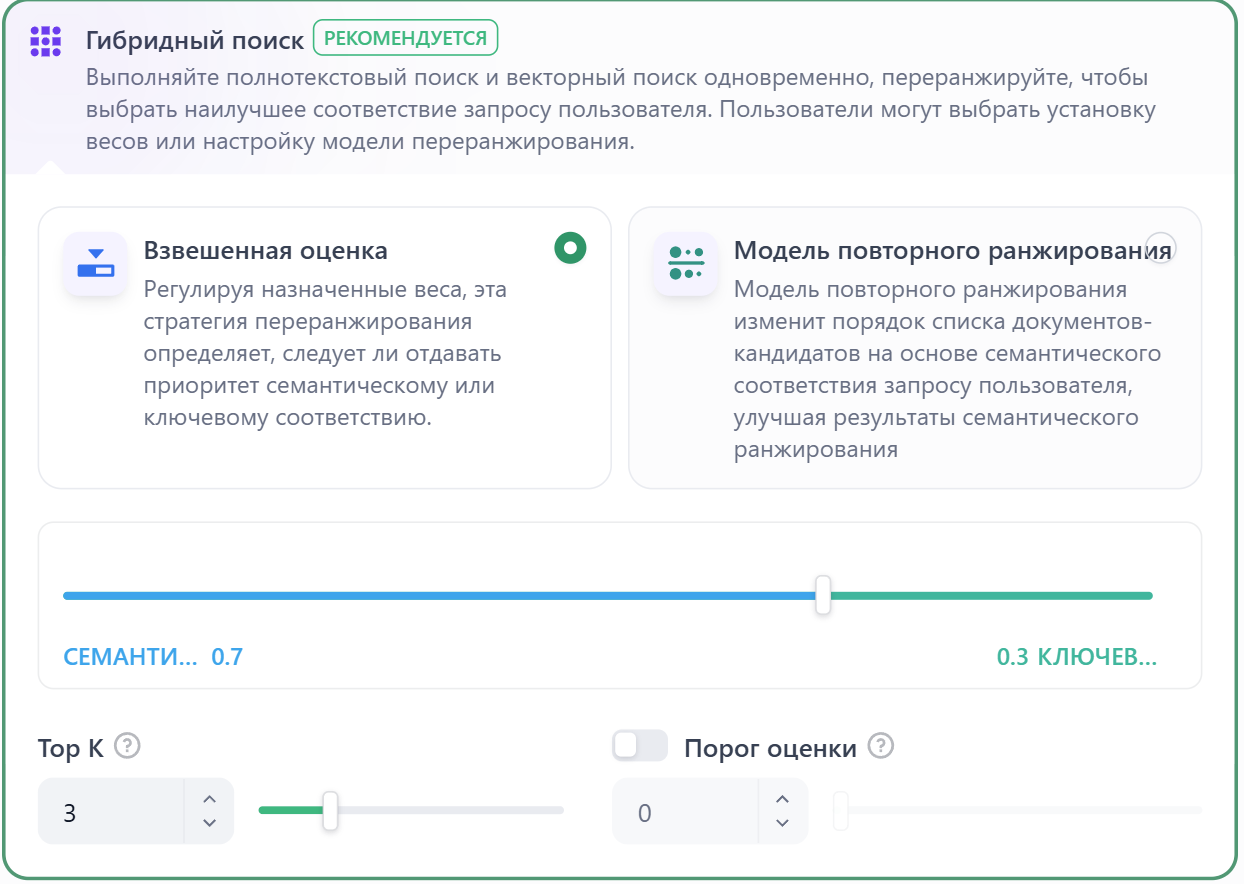 В этом режиме вы можете задать «Настройки веса» без необходимости настраивать API реранк-модели или включить реранк-модель для поиска.
Если выбранная эмбеддинг-модель мультимодальная, выберите также мультимодальную реранк-модель (отмеченную значком Распознавание изображений). Иначе найденные изображения будут исключены из реранкинга и из результатов поиска.
Включение этой функции расходует токены реранк-модели. Подробнее — на странице тарифов соответствующей модели.TopK: определяет, сколько чанков текста, признанных наиболее похожими на запрос пользователя, извлекается. Также автоматически корректирует число чанков в зависимости от контекстного окна выбранной модели. Значение по умолчанию — 3; большие значения возвращают больше чанков текста.Порог оценки: задаёт минимальную оценку сходства, необходимую для извлечения чанка. Извлекаются только чанки, превышающие эту оценку. Значение по умолчанию — 0.5. Более высокие пороги требуют большего сходства и поэтому приводят к извлечению меньшего числа чанков.
Настройки Top K и порога оценки действуют только на этапе реранкинга. Поэтому, чтобы применить любую из них, необходимо добавить и включить реранк-модель.Полнотекстовый поискОпределение: индексирует все термины в документе, позволяя пользователям искать любые термины и возвращать текстовые фрагменты, содержащие эти термины.
Если выбранная эмбеддинг-модель мультимодальная, выберите также мультимодальную реранк-модель (отмеченную значком Распознавание изображений). Иначе найденные изображения будут исключены из реранкинга и из результатов поиска.
Включение этой функции расходует токены реранк-модели. Подробнее — на странице тарифов соответствующей модели.TopK: определяет, сколько чанков текста, признанных наиболее похожими на запрос пользователя, извлекается. Также автоматически корректирует число чанков в зависимости от контекстного окна выбранной модели. Значение по умолчанию — 3; большие значения возвращают больше чанков текста.Порог оценки: задаёт минимальную оценку сходства, необходимую для извлечения чанка. Извлекаются только чанки, превышающие эту оценку. Значение по умолчанию — 0.5. Более высокие пороги требуют большего сходства и поэтому приводят к извлечению меньшего числа чанков.
Настройки Top K и порога оценки действуют только на этапе реранкинга. Поэтому, чтобы применить любую из них, необходимо добавить и включить реранк-модель.Гибридный поискОпределение: этот процесс объединяет полнотекстовый и векторный поиск, выполняя оба одновременно. Он включает этап переупорядочивания, на котором из результатов обоих видов поиска выбираются наиболее подходящие под запрос пользователя.
-
Настройки веса
Эта функция позволяет пользователям задавать собственные веса для приоритета семантики и приоритета ключевых слов. Поиск по ключевым словам означает выполнение полнотекстового поиска внутри базы знаний, а семантический поиск подразумевает векторный поиск внутри базы знаний.
- Значение семантики, равное 1 Активирует только режим семантического поиска. Используя эмбеддинг-модели, поиск может — даже если точные термины из запроса не встречаются в базе знаний — углубиться, вычисляя векторные расстояния, и тем самым вернуть релевантный контент. Кроме того, при работе с многоязычным контентом семантический поиск способен улавливать смысл в разных языках, обеспечивая более точные результаты межъязыкового поиска.
- Значение ключевых слов, равное 1 Активирует только режим поиска по ключевым словам. Выполняет полное совпадение с введённым текстом в базе знаний; подходит для сценариев, когда пользователь знает точную информацию или терминологию. Этот подход потребляет меньше вычислительных ресурсов и идеален для быстрого поиска в большой базе знаний из документов.
- Пользовательские веса ключевых слов и семантики Помимо включения только семантического поиска или только поиска по ключевым словам, мы предоставляем гибкие настройки пользовательских весов. Вы можете непрерывно корректировать веса двух методов, чтобы подобрать оптимальное соотношение весов под ваш бизнес-сценарий. Модель повторного ранжирования
Если выбранная эмбеддинг-модель мультимодальная, выберите также мультимодальную реранк-модель (отмеченную значком Распознавание изображений). Иначе найденные изображения будут исключены из реранкинга и из результатов поиска.Включение этой функции расходует токены реранк-модели. Подробнее — на странице тарифов соответствующей модели.
Справочные материалы
После указания настроек поиска вы можете обратиться к следующей документации, чтобы изучить, как ключевые слова сопоставляются с чанками контента в различных сценариях.Тестирование поиска по базе знаний
Узнайте, как тестировать и цитировать результаты поиска по вашей базе знаний