Настройка
Написание промпта
Промпт сообщает модели, что делать, как отвечать и какие ограничения соблюдать. Поскольку Text Generator выполняется за один проход без истории диалога, промпт — единственный источник контекста для модели. Включите в него всё, что нужно для получения правильного вывода за один проход. Вот несколько советов по написанию эффективных промптов:- Чётко определите задачу: укажите, что модель должна произвести (например, перевод, краткое изложение, SQL-выражение).
- Задайте формат вывода: опишите ожидаемую структуру, длину или стиль.
- Установите ограничения: сообщите модели, чего следует избегать и какие правила соблюдать.
query типа «абзац». Вы можете переименовать query или изменить её тип.
Переменные — это заполнители: каждая из них становится полем ввода, которое пользователи заполняют перед запуском приложения, а их значения подставляются в промпт во время выполнения. Например:
- Короткий текст
- Абзац
- Выбор
- Число
- Флажок
- Переменная на основе API
Принимает до 256 символов. Используйте для имён, адресов электронной почты, заголовков или любого короткого текста, помещающегося в одну строку.
Имя метки — это то, что конечные пользователи видят для каждого поля ввода.
Создание динамических промптов с помощью переменных
Чтобы адаптировать приложение к разным пользователям или контекстам, не переписывая промпт каждый раз, добавьте больше переменных. Каждая переменная заранее собирает определённую часть информации и внедряет её в промпт во время выполнения. Например, генератор SQL может использоватьdatabase_type для адаптации диалекта вывода, а query — для перехвата запроса пользователя на естественном языке:
Генерация или улучшение промпта с помощью ИИ
Если вы не знаете, с чего начать, или хотите доработать существующий промпт, нажмите Сгенерировать, чтобы LLM помогла вам составить черновик. Опишите желаемый результат с нуля или сошлитесь наcurrent_prompt и укажите, что нужно улучшить. Для более точных результатов добавьте пример в Идеальный результат.
Каждая генерация сохраняется как версия, поэтому вы можете свободно экспериментировать и откатываться.
Привязка ответов к собственным данным
Чтобы ответы модели опирались на ваши собственные данные, а не на общие знания, добавьте базу знаний и выберите существующую переменную в качестве Переменной запроса. Когда пользователь запускает приложение и заполняет это поле, его значение используется как поисковый запрос для извлечения релевантного контента из базы знаний. Затем извлечённый контент внедряется в промпт как контекст, чтобы модель могла сгенерировать более обоснованный ответ.Пример: использование типа контента для извлечения руководств по стилю в приложении для написания контента
Пример: использование типа контента для извлечения руководств по стилю в приложении для написания контента
Например, предположим, что ваша база знаний содержит руководства по стилю для разных типов контента — записей в блог, подписей в социальных сетях, описаний товаров и так далее.В приложении для написания контента задайте
content_type как Переменную запроса. Когда пользователь выбирает тип контента, приложение извлекает подходящее руководство по стилю и генерирует текст, соответствующий нужным стандартам письма.Ваш промпт может выглядеть так:Настройка параметров поиска на уровне приложения
Чтобы точно настроить обработку результатов поиска, нажмите Настройки извлечения.Существует два уровня настроек поиска — уровень базы знаний и уровень приложения.Воспринимайте их как два последовательных фильтра: настройки базы знаний определяют исходный набор результатов, а настройки приложения дополнительно ранжируют результаты или сужают набор.
-
Настройки реранкинга
- Взвешенная оценка Относительный вес между семантическим сходством и совпадением по ключевым словам при реранкинге. Больший семантический вес отдаёт предпочтение релевантности по смыслу, а больший вес ключевых слов — точным совпадениям. Взвешенная оценка доступна только тогда, когда все добавленные базы знаний индексированы в режиме Высокое качество.
-
Модель повторного ранжирования
Реранк-модель, которая заново оценивает и переупорядочивает все результаты по их релевантности запросу.
Если добавлены мультимодальные базы знаний, выберите также мультимодальную реранк-модель (отмеченную тегом Распознавание изображений). Иначе извлечённые изображения будут исключены из реранкинга и из итогового вывода.
- Top K Максимальное число лучших результатов, возвращаемых после реранкинга. Когда выбрана реранк-модель, это значение автоматически корректируется в зависимости от максимальной входной ёмкости модели (сколько текста модель может обработать за раз).
- Порог оценки Минимальная оценка сходства для возвращаемых результатов. Результаты с оценкой ниже этого порога исключаются. Используйте более высокие пороги для строгой релевантности или более низкие — для включения более широких совпадений.
Поиск в пределах определённых документов
По умолчанию поиск выполняется по всей базе знаний. Чтобы ограничить поиск определёнными документами, включите ручную или автоматическую фильтрацию метаданных. Это повышает точность поиска, особенно когда ваша база знаний велика или содержит контент для разных контекстов. О создании метаданных документов и управлении ими см. Метаданные.Обработка мультимодального ввода
Чтобы разрешить конечным пользователям загружать файлы, выберите модель с соответствующими мультимодальными возможностями. Нужные переключатели типов файлов — Распознавание изображений, Аудио или Документ — появляются, как только модель их поддерживает, и вы можете включить каждый по необходимости.Поддерживаемые моделью модальности можно быстро определить по её тегам.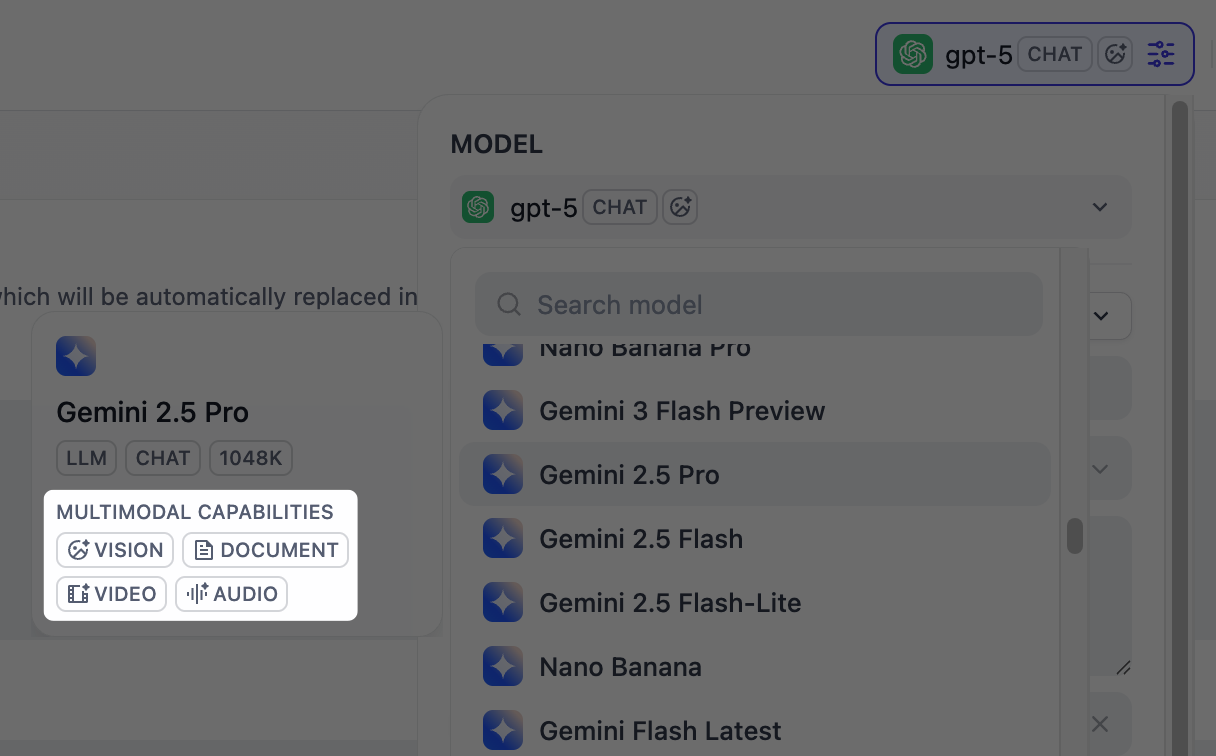
-
Разрешение: управляет уровнем детализации только для обработки изображений.
- Высокое: лучшая точность для сложных изображений, но использует больше токенов
- Низкое: более быстрая обработка с меньшим числом токенов для простых изображений
- Метод загрузки: выберите, могут ли пользователи загружать файлы с устройства, вставлять URL или и то, и другое.
- Лимит загрузки: максимальное число файлов, которое пользователь может загрузить за один запуск.
Для самостоятельно размещённых развёртываний размер файлов можно настроить через следующие переменные среды:
UPLOAD_IMAGE_FILE_SIZE_LIMIT(по умолчанию: 10 MB)UPLOAD_FILE_SIZE_LIMIT(по умолчанию: 15 MB)UPLOAD_AUDIO_FILE_SIZE_LIMIT(по умолчанию: 50 MB)
Отладка и предпросмотр
В панели предпросмотра справа протестируйте приложение в реальном времени. Выберите модель, которая лучше всего подходит для вашей задачи, заполните поля ввода и нажмите Запуск, чтобы увидеть вывод. После выбора модели вы можете настроить её параметры, чтобы управлять тем, как она генерирует ответы. Доступные параметры и пресеты зависят от модели.Чтобы сравнить выводы разных моделей, нажмите Отладка как нескольких моделей для одновременного запуска до 4 моделей.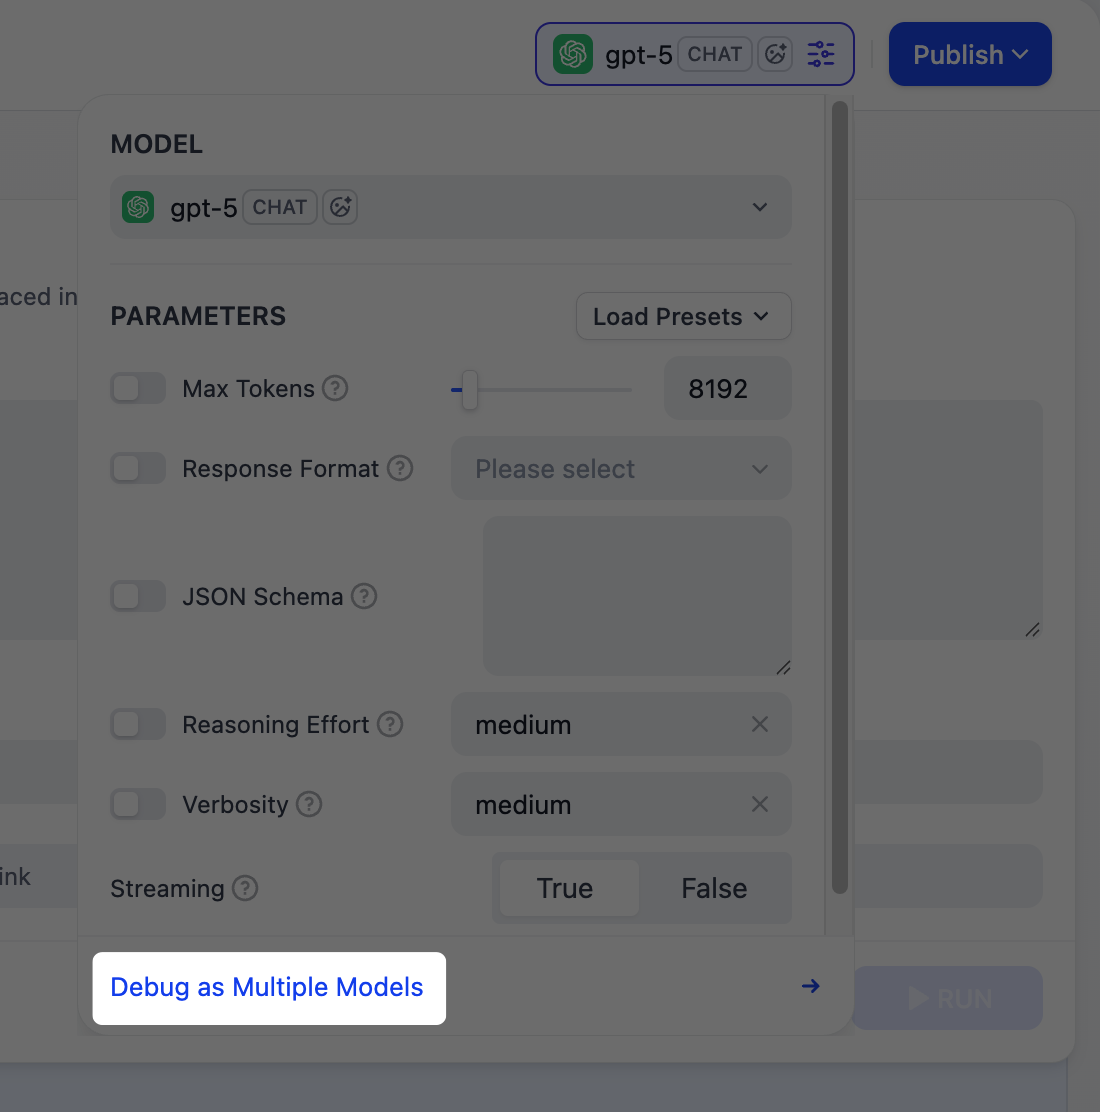
Публикация
Когда результат вас устраивает, нажмите Опубликовать, чтобы сделать приложение доступным. Полный список вариантов публикации см. в Опубликовать. При работе с веб-приложением конечные пользователи могут сохранять отдельные выводы для дальнейшего использования.