

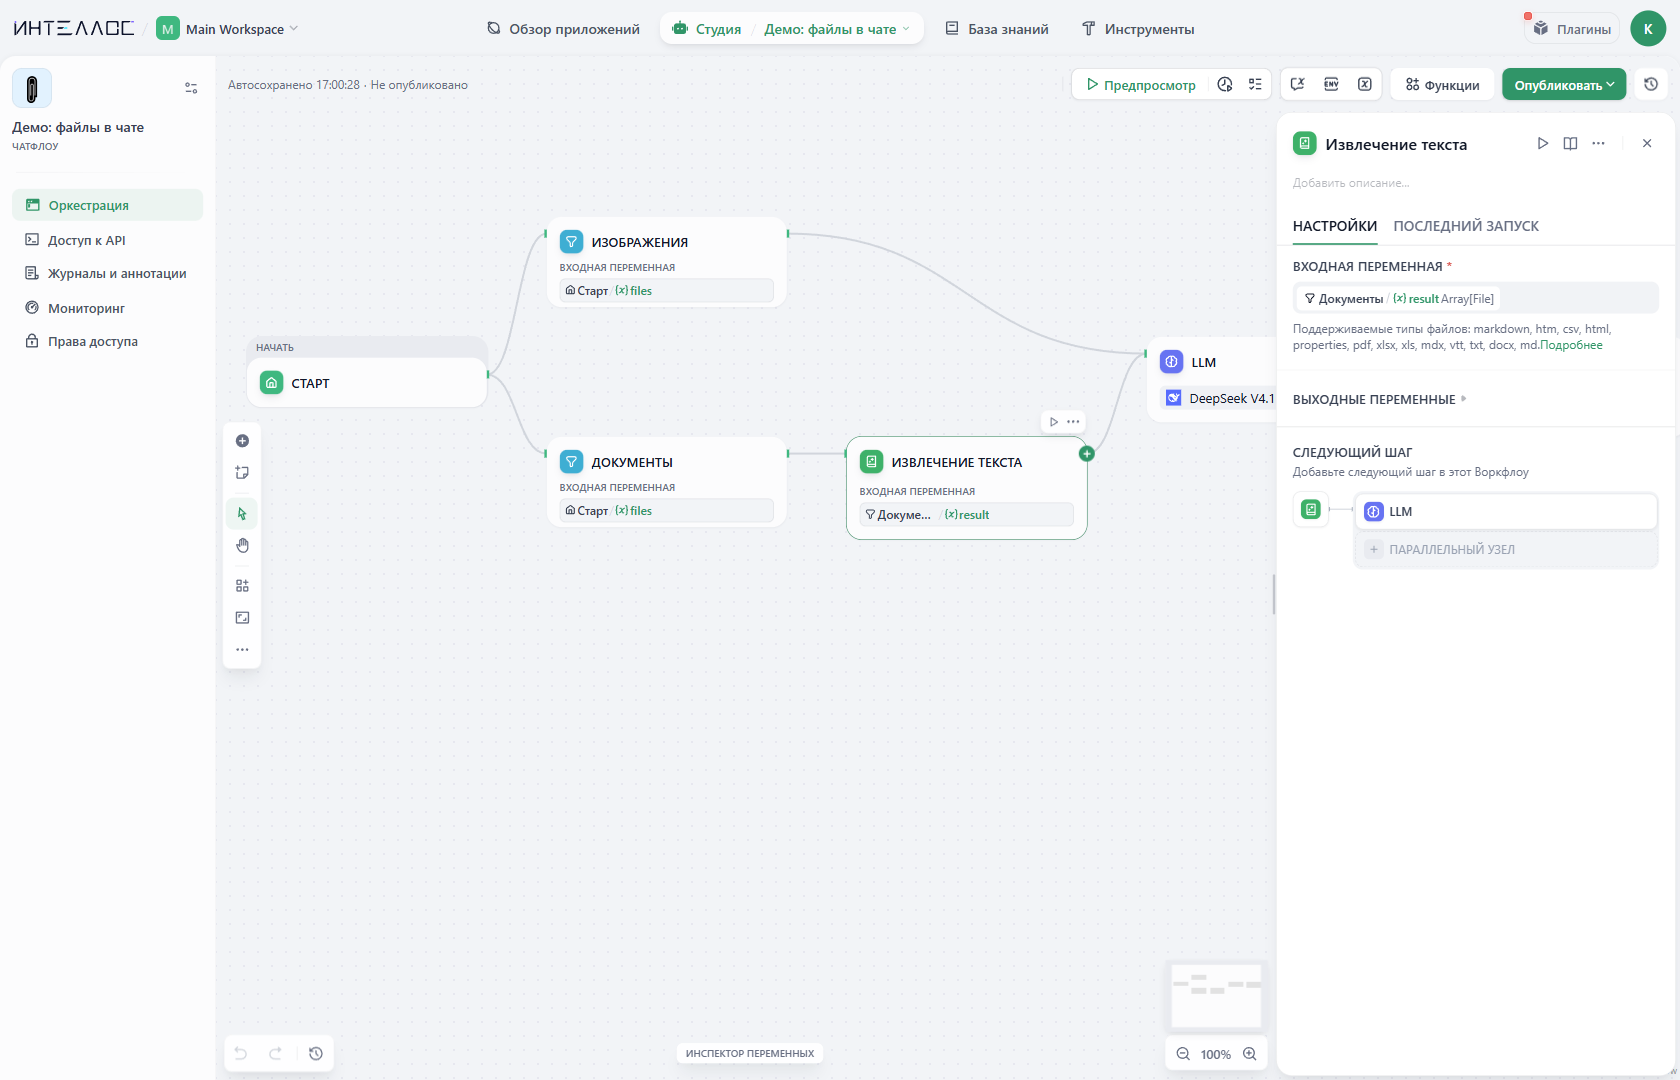
Конфигурация узла «Экстрактор документов»
Поддерживаемые типы файлов
Узел работает с большинством текстовых форматов документов: Текстовые документы — файлы TXT, Markdown, HTML с непосредственным текстовым содержимым Документы Office — файлы DOCX из Microsoft Word и совместимых приложений Документы PDF — текстовые PDF, обрабатываемые библиотекой pypdfium2 для точного извлечения текста Файлы Office — файлы DOC требуют Unstructured API, файлы DOCX поддерживают прямой разбор с извлечением таблиц и преобразованием их в формат Markdown Электронные таблицы — файлы Excel (.xls/.xlsx) и CSV, преобразуемые в таблицы Markdown Презентации — файлы PowerPoint (.ppt/.pptx), обрабатываемые через Unstructured API Форматы электронной почты — файлы EML и MSG для извлечения содержимого писем Специализированные форматы — книги EPUB, субтитры VTT, данные JSON/YAML и файлы Properties Файлы, содержащие преимущественно бинарные данные (изображения, аудио или видео), требуют специализированных инструментов обработки или внешних сервисов.Ввод и вывод
Конфигурация ввода
Настройте узел для приёма одного из вариантов: Один файл из файловой переменной (обычно из узла «Начало») Несколько файлов в виде массива для пакетной обработки документовСтруктура вывода
Узел выводит извлечённое текстовое содержимое:- При вводе одного файла формируется
stringс извлечённым текстом - При вводе нескольких файлов формируется
array[string], где каждый элемент содержит текст соответствующего файла
text и содержит исходное текстовое содержимое, готовое к дальнейшей обработке.
Пример реализации
Ниже приведён полноценный рабочий процесс вопросов и ответов по документу с использованием «Экстрактора документов»: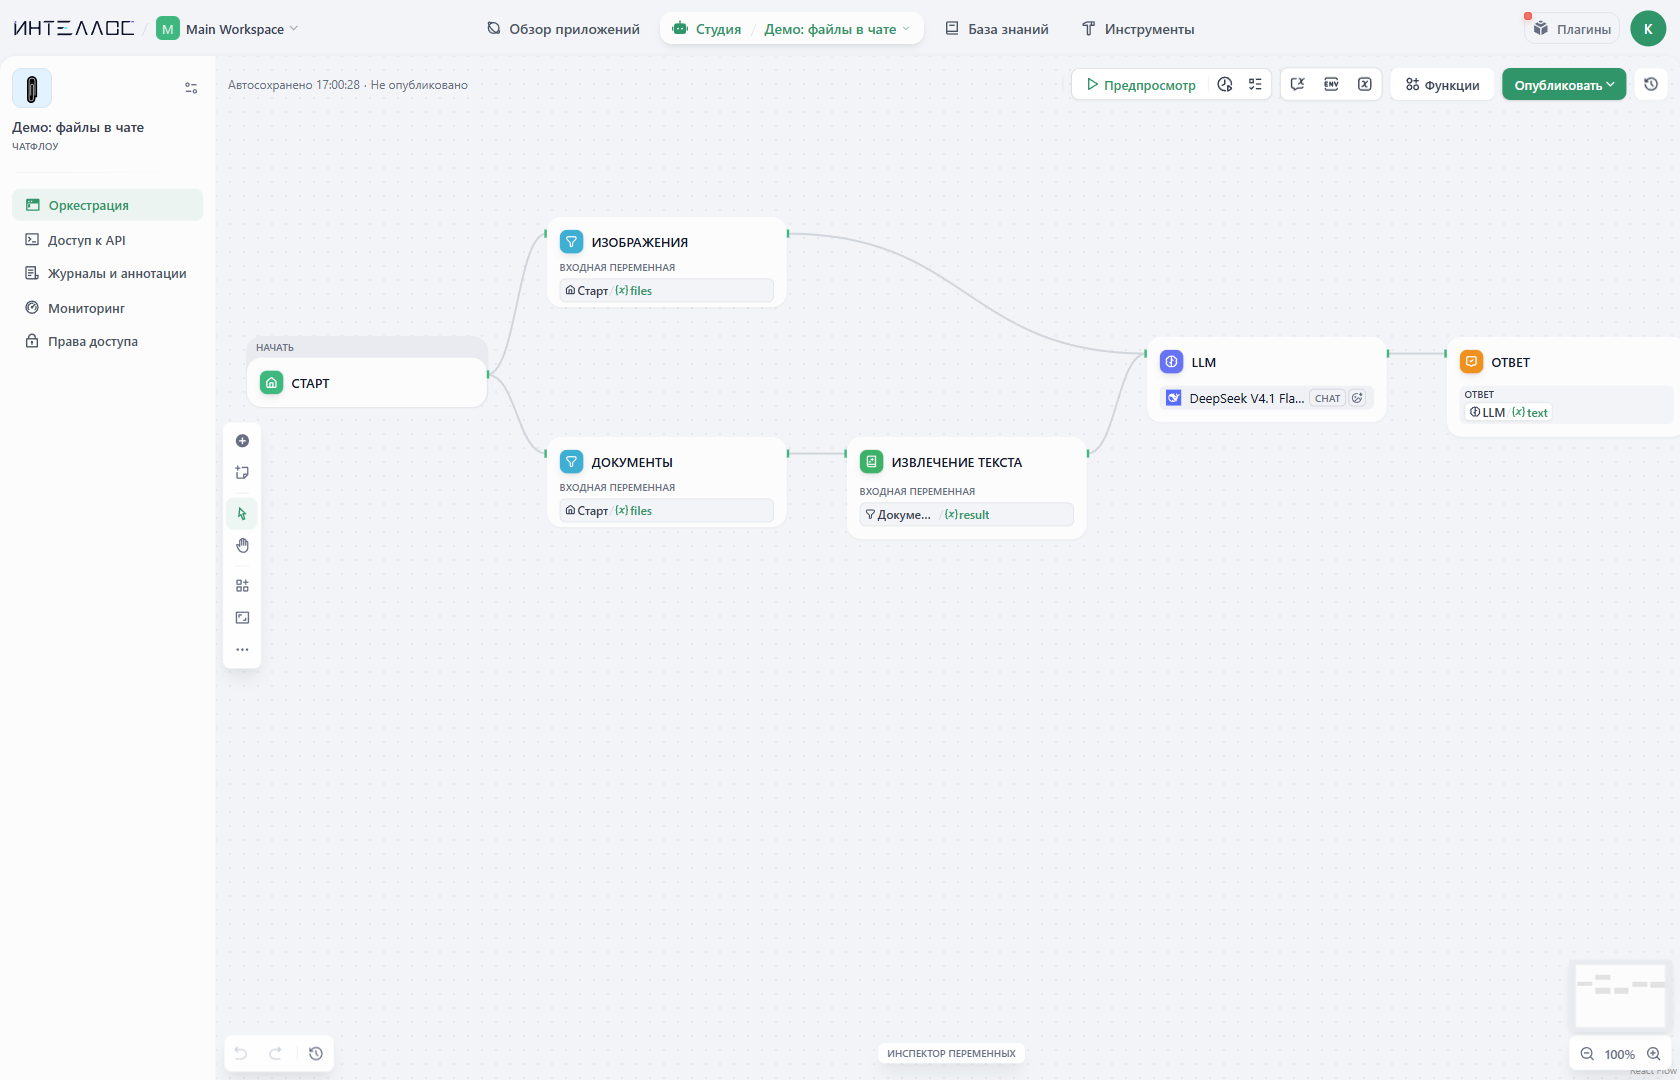
Реализация рабочего процесса в стиле ChatPDF
Настройка рабочего процесса
Настройка загрузки файлов — включите ввод файлов в узле «Начало», чтобы принимать загружаемые пользователями документы. Извлечение текста — подключите «Экстрактор документов» для обработки загруженных файлов и извлечения их текстового содержимого. Обработка ИИ — используйте извлечённый текст в промптах LLM для анализа, реферирования или ответов на вопросы.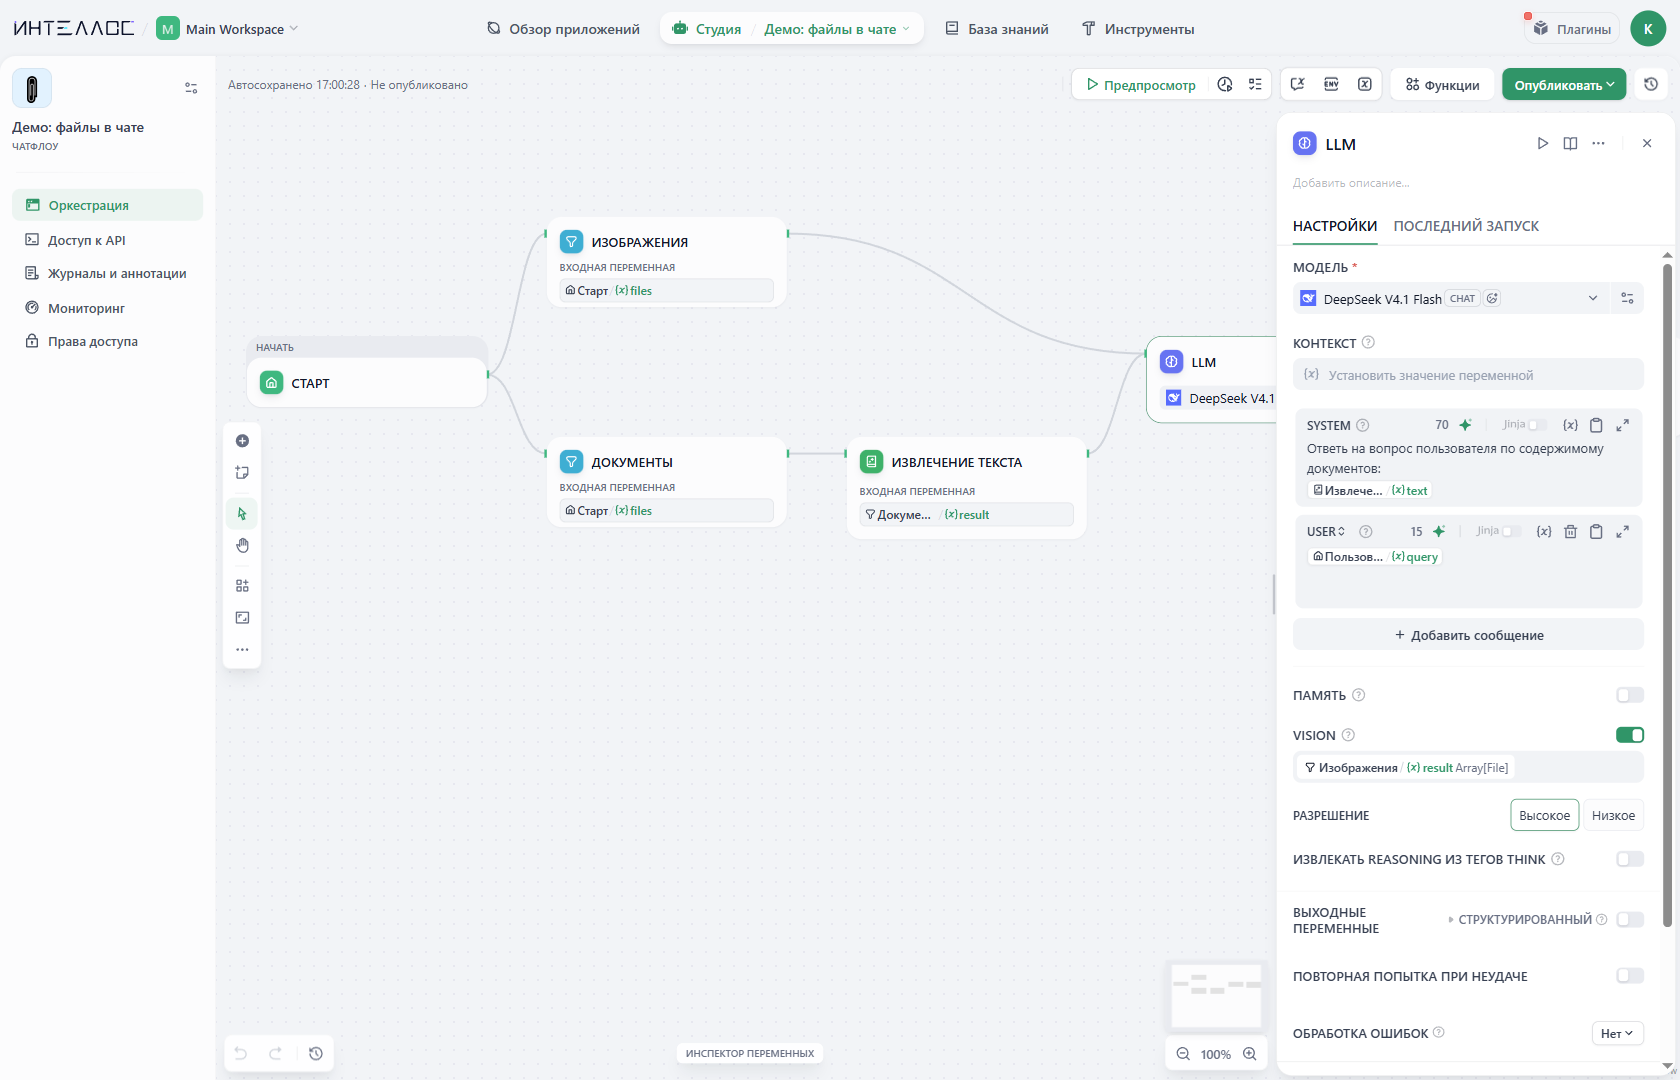
Обработка документов в действии
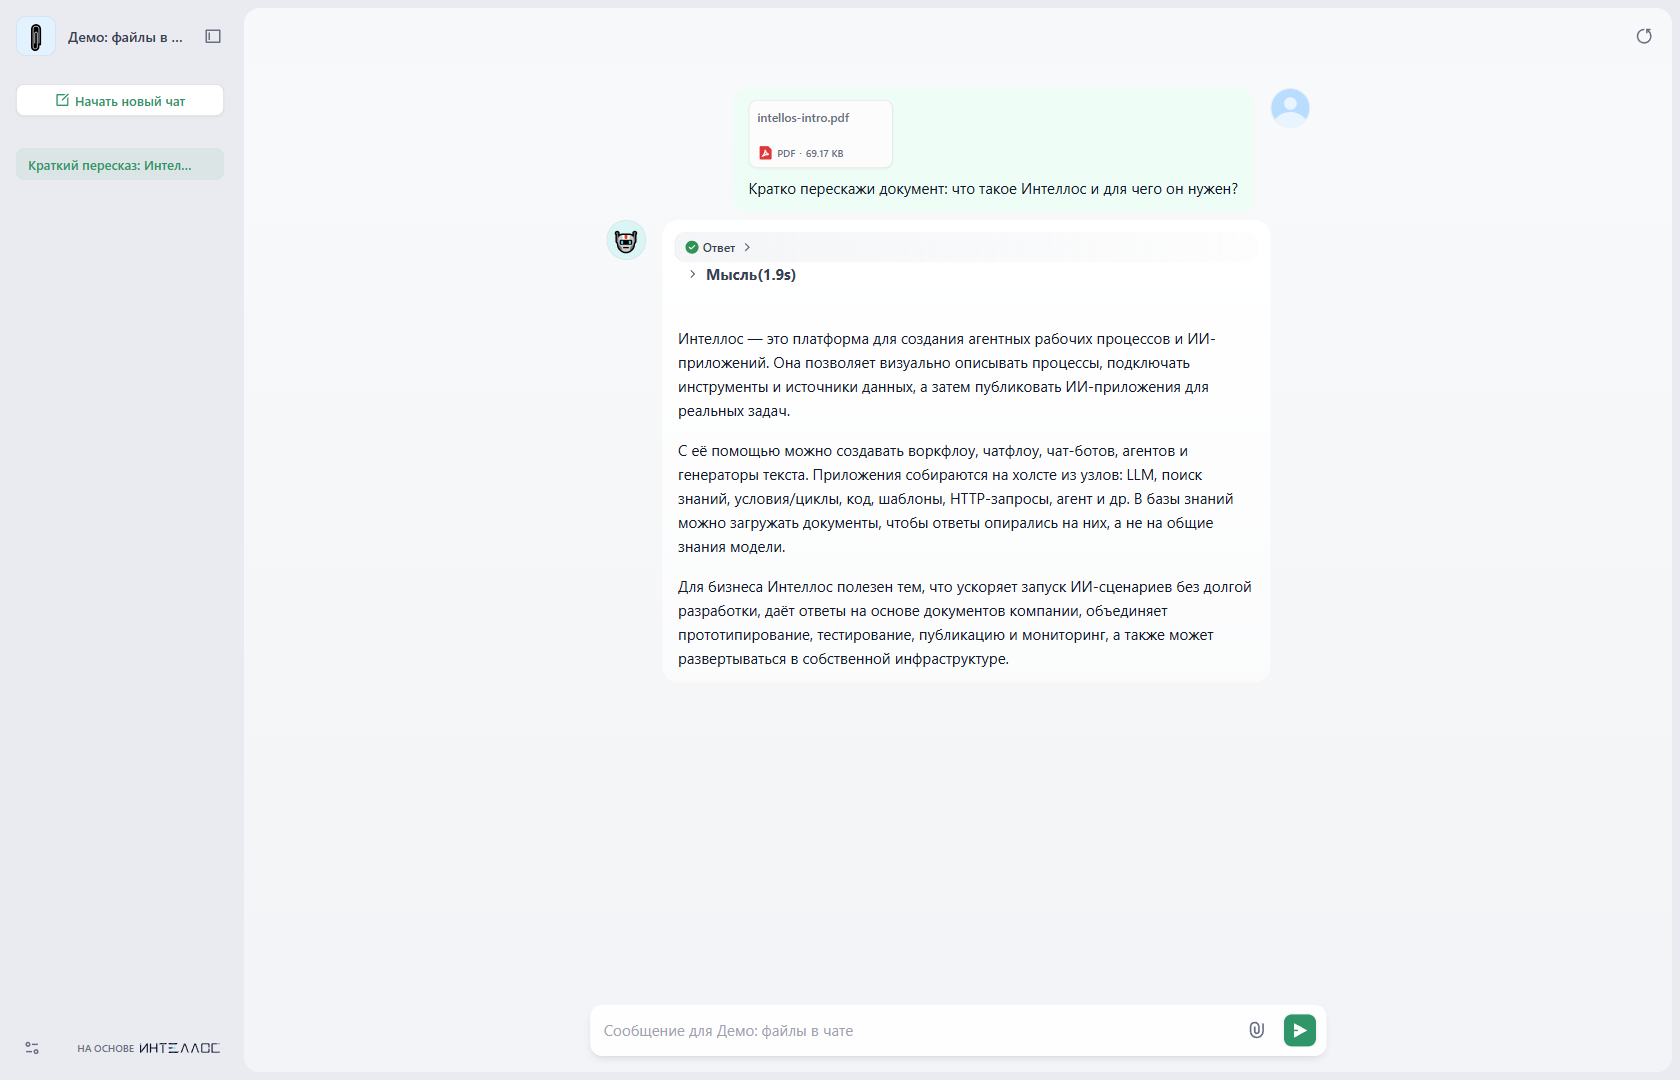
Интерфейс чата с загрузкой документа
Особенности обработки
«Экстрактор документов» использует специализированные библиотеки разбора, оптимизированные под разные форматы файлов. Он сохраняет структуру и форматирование текста там, где это возможно, делая извлечённое содержимое более пригодным для обработки LLM.Обработка форматов файлов
Определение кодировки — для текстовых файлов используется библиотека chardet, которая автоматически определяет кодировку файла с откатом к UTF-8 Преобразование таблиц — данные Excel и CSV превращаются в таблицы Markdown для лучшего восприятия LLM Структура документа — файлы DOCX сохраняют порядок абзацев и таблиц с корректным преобразованием таблиц в Markdown Многострочное содержимое — файлы субтитров VTT объединяют последовательные реплики одного и того же говорящегоВнешние зависимости
Некоторые форматы файлов требуют сервиса Unstructured API, настраиваемого черезUNSTRUCTURED_API_URL и UNSTRUCTURED_API_KEY:
- Файлы DOC (устаревшие документы Word)
- Презентации PowerPoint (при обработке через API)
- Книги EPUB (при обработке через API)