

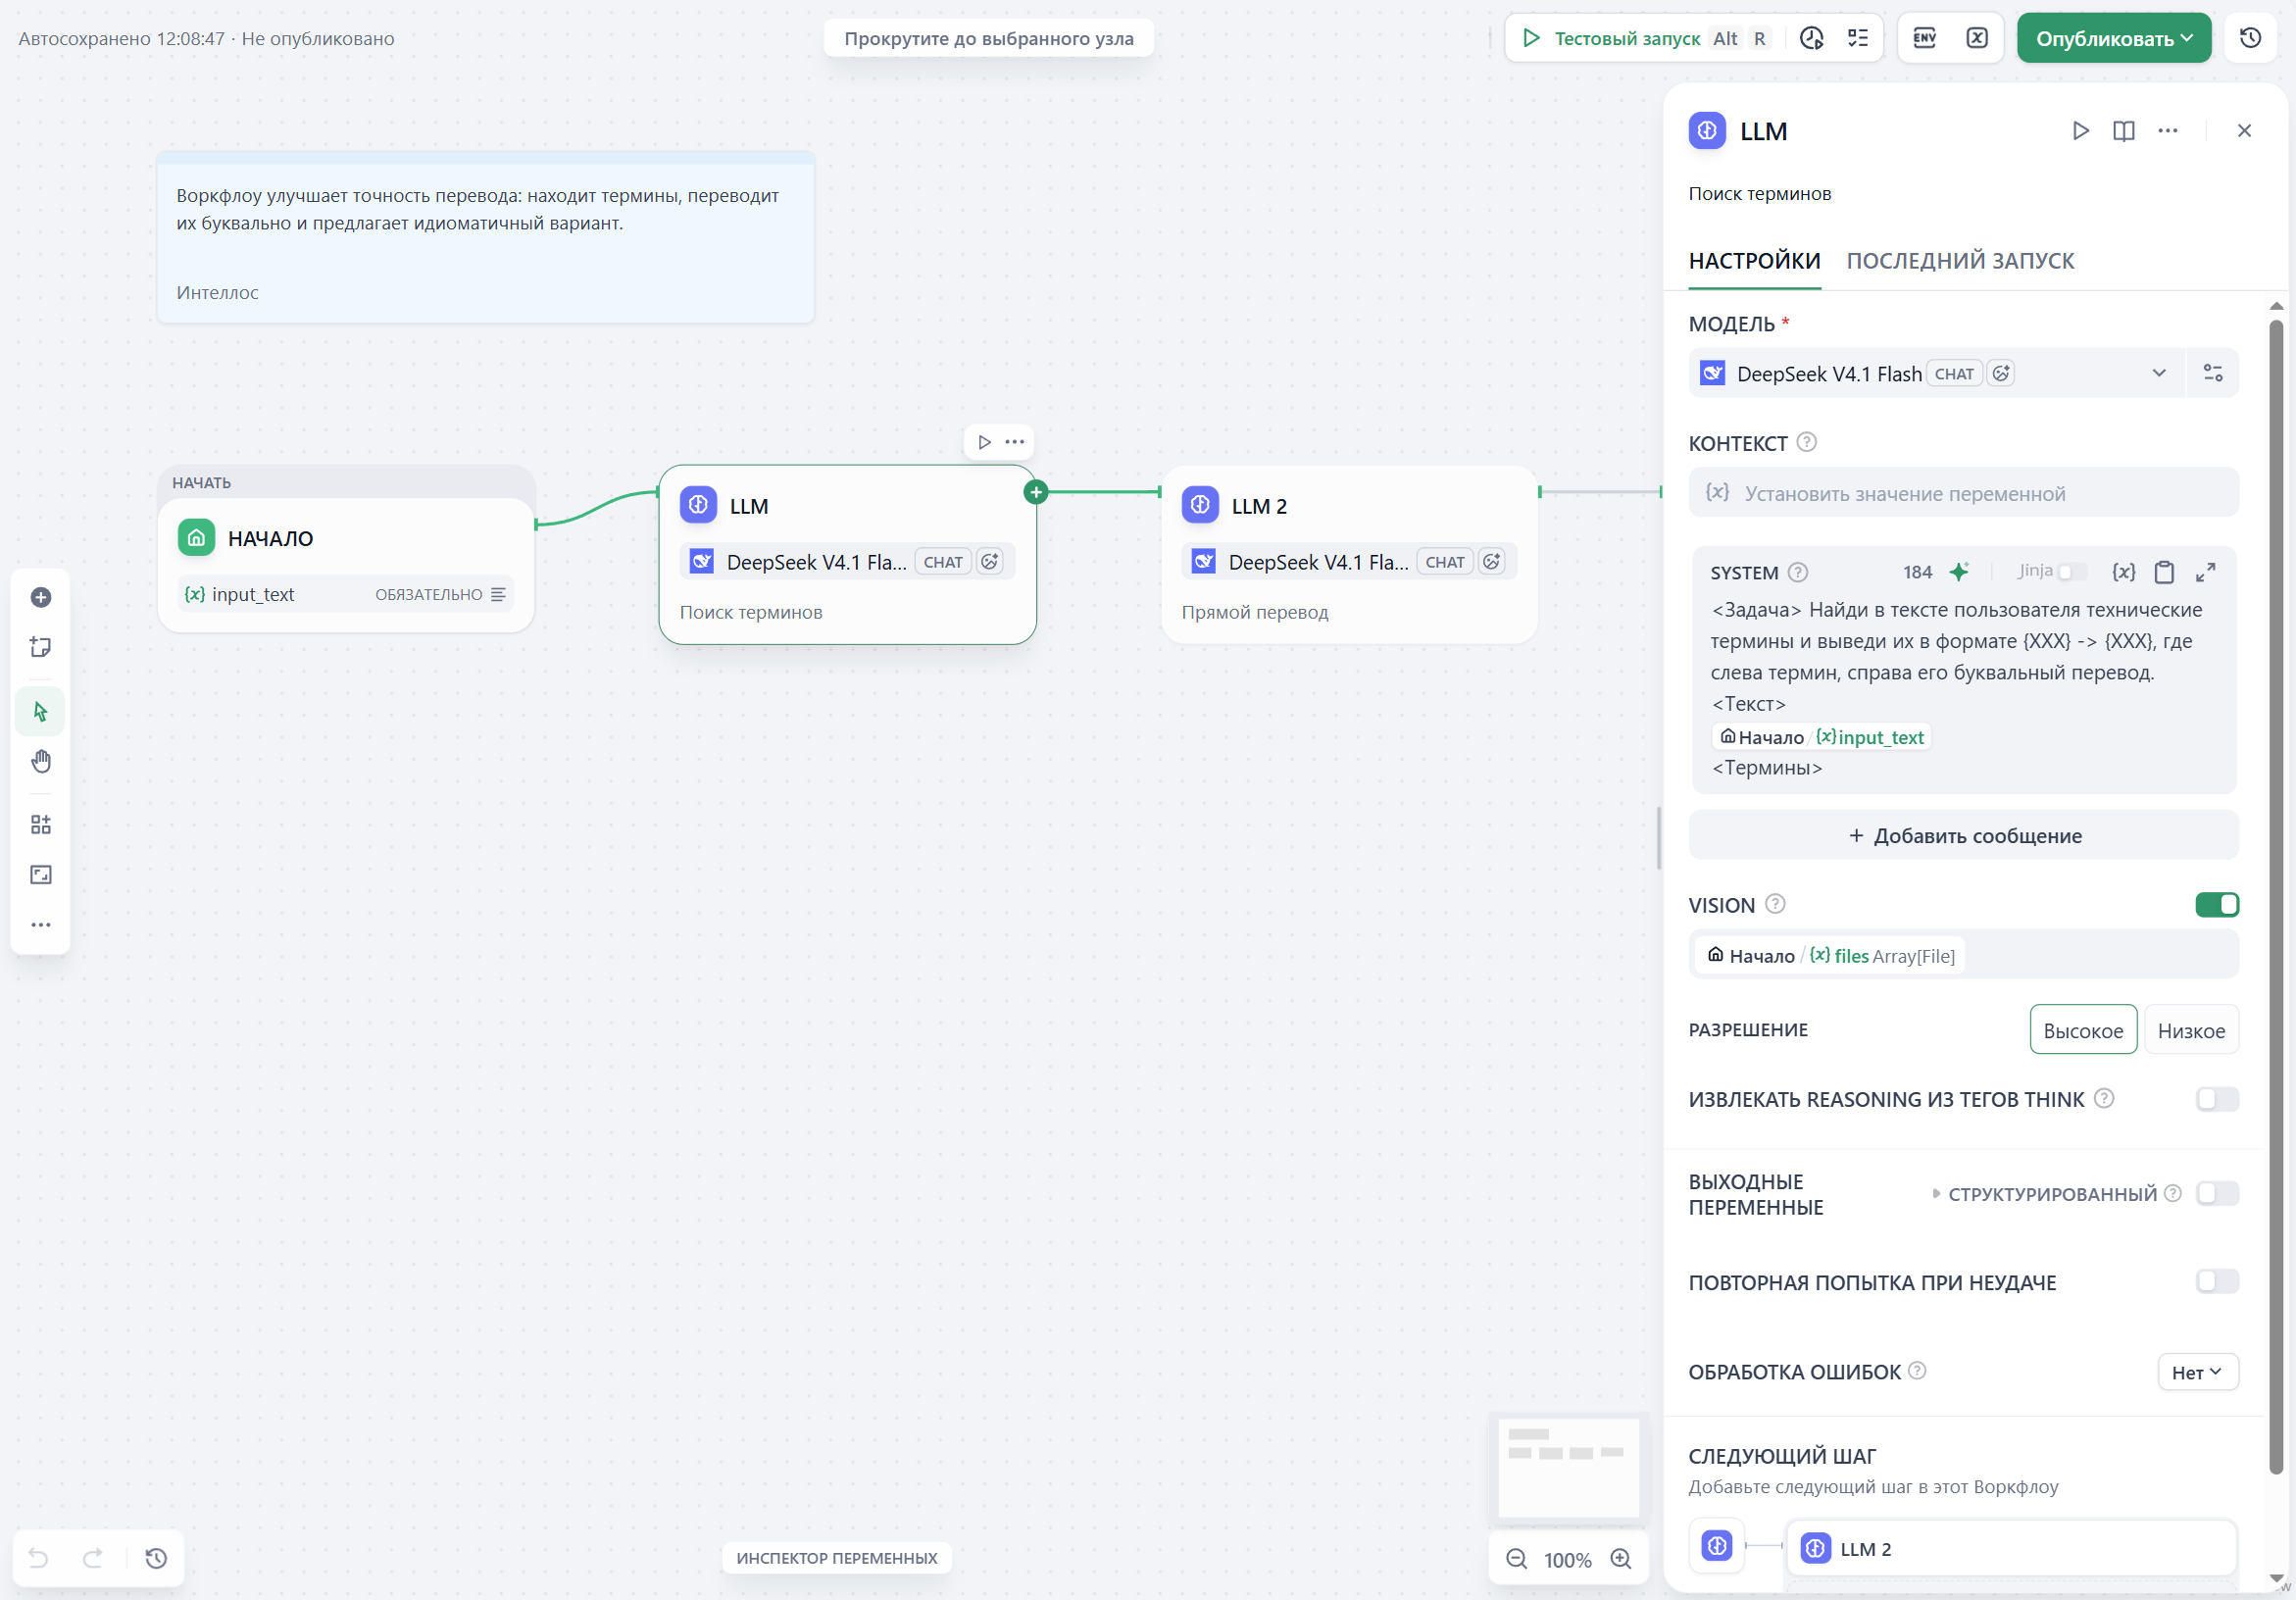
Интерфейс настройки узла LLM
Перед использованием узлов LLM настройте хотя бы одного поставщика модели в разделе Настройки → Поставщик модели.
Выбор модели и параметры
Выбирайте из любого настроенного вами поставщика модели. Разные модели хороши в разных задачах: GPT-4 и Claude 3.5 хорошо справляются со сложными рассуждениями, но стоят дороже, тогда как GPT-3.5 Turbo сочетает возможности с доступной ценой. Для локального развёртывания используйте Ollama, LocalAI или Xinference.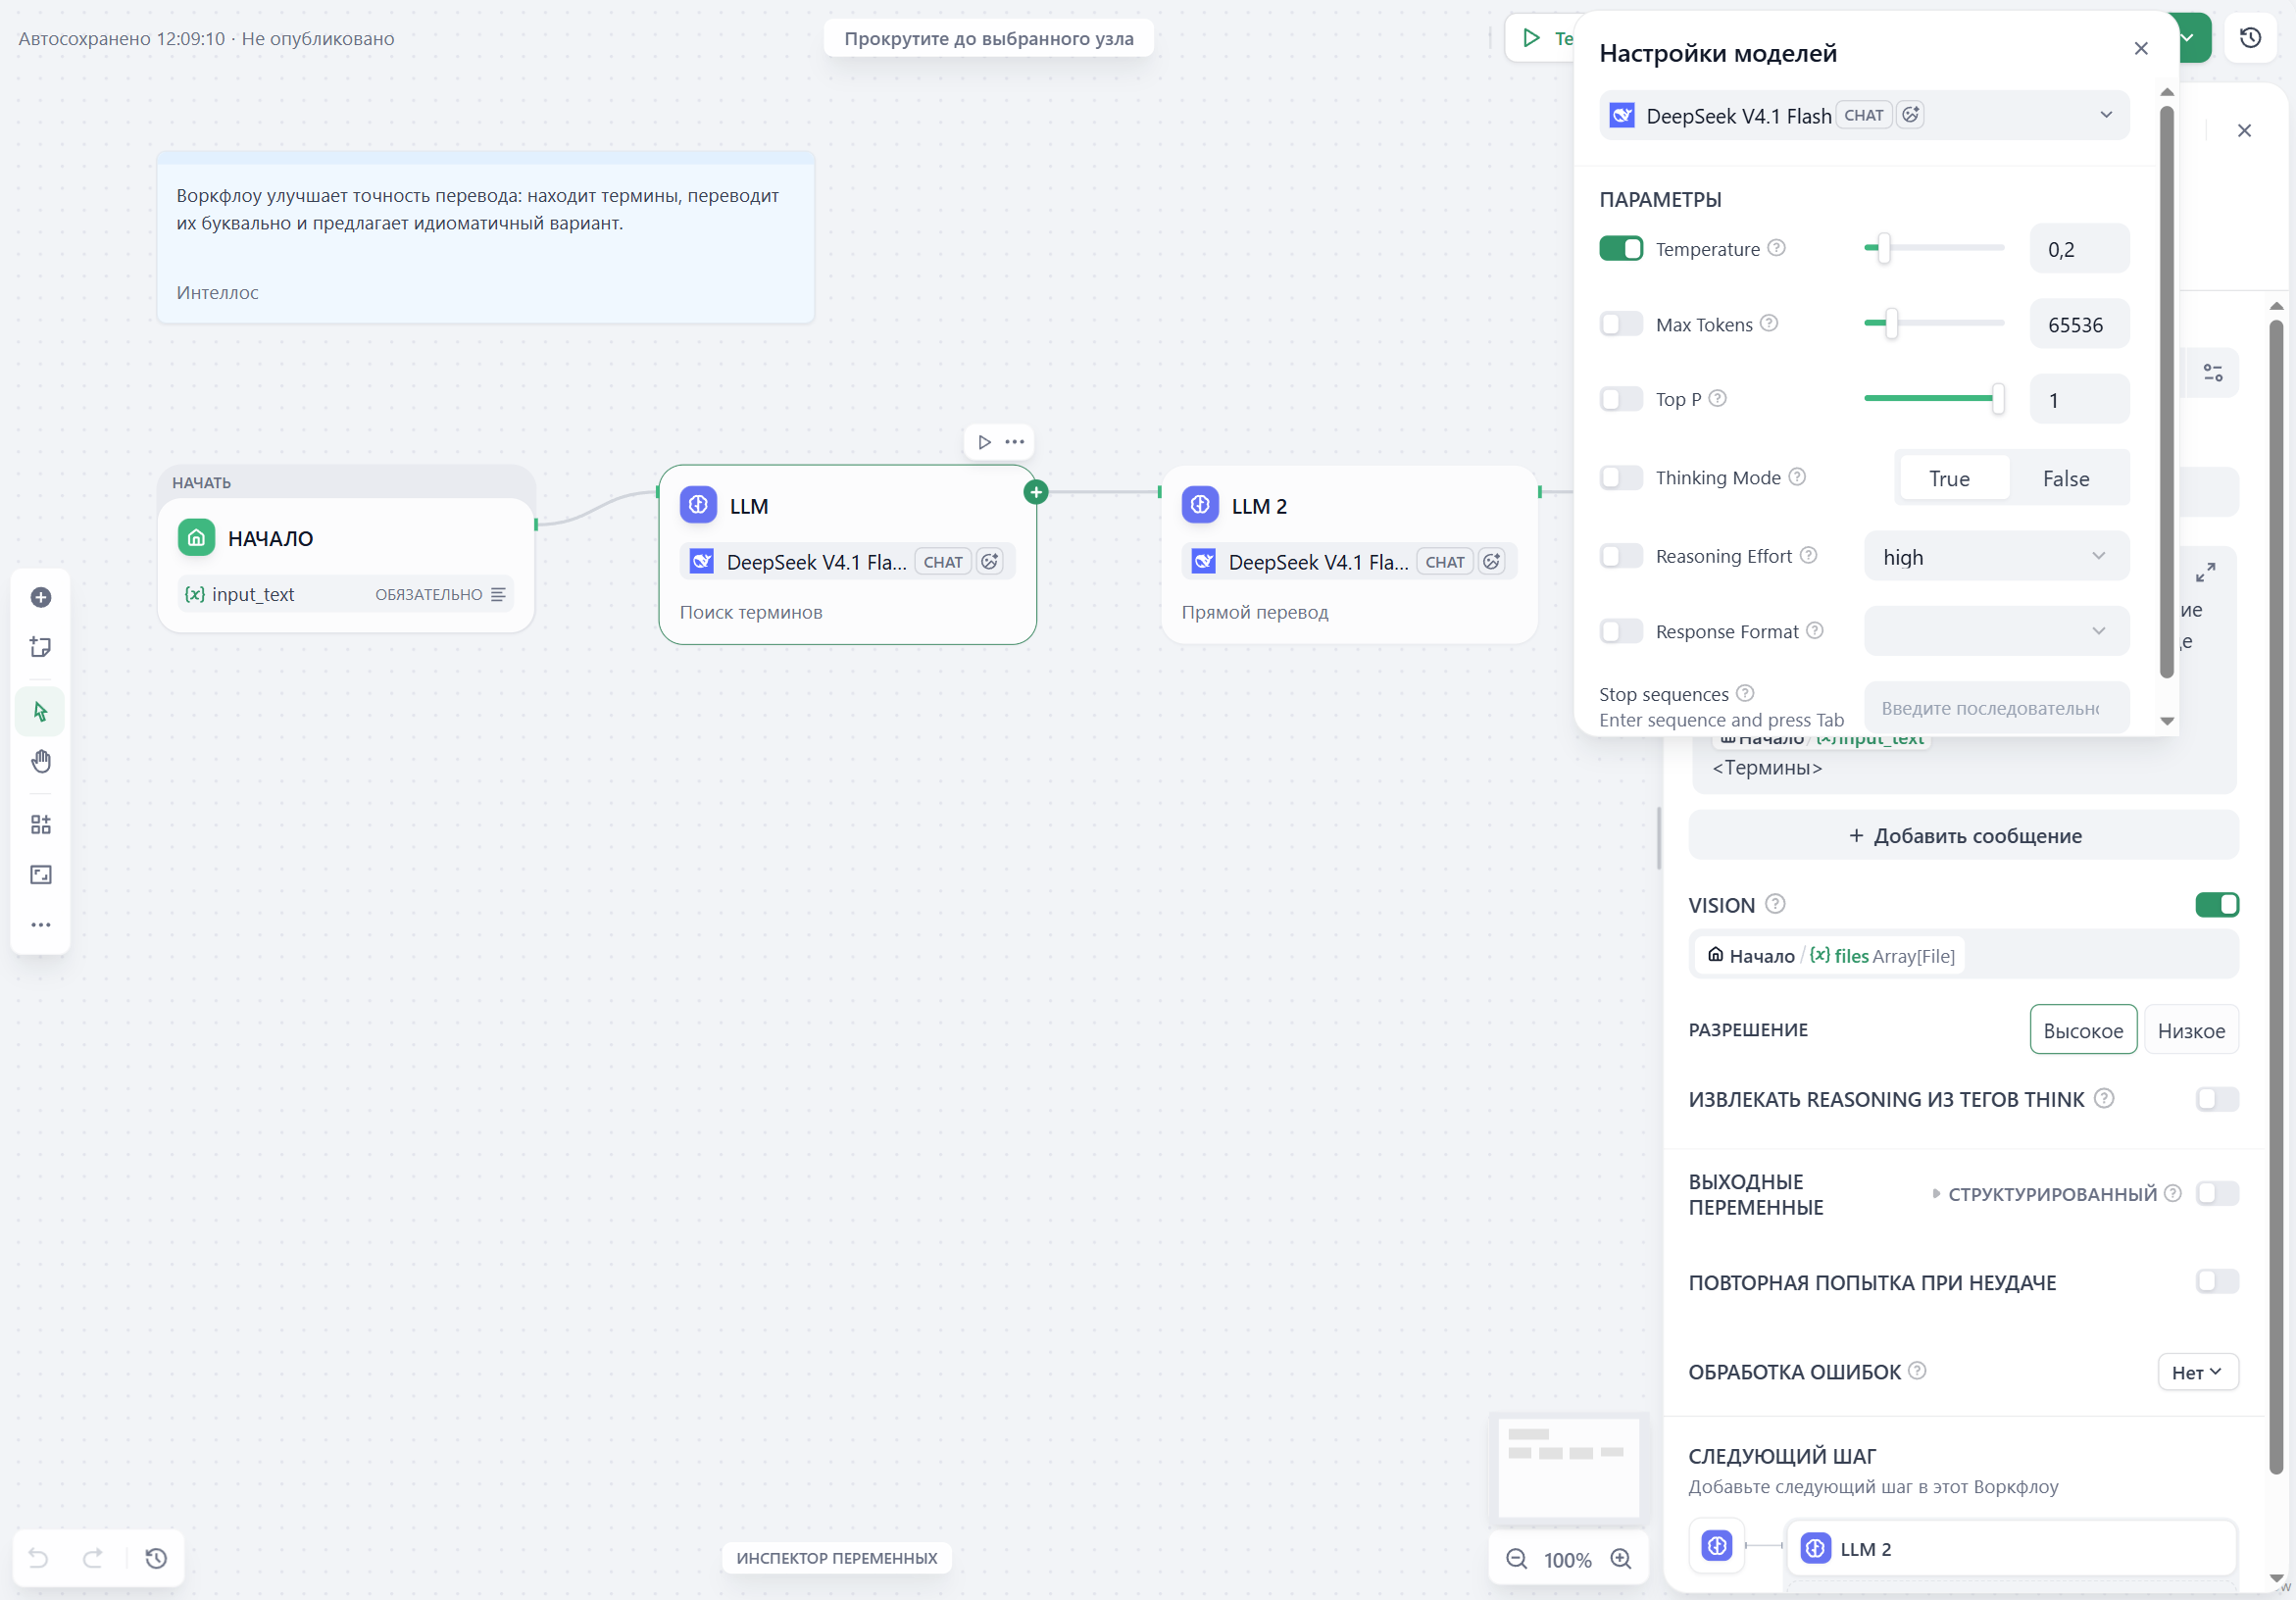
Выбор модели и настройка параметров
Настройка промпта
Интерфейс адаптируется в зависимости от типа модели. Чат-модели используют роли сообщений (Система — для поведения, Пользователь — для ввода, Ассистент — для примеров), тогда как модели завершения текста используют простое продолжение текста. Ссылайтесь на переменные рабочего процесса в промптах с помощью двойных фигурных скобок:{{variable_name}}. Переменные заменяются фактическими значениями до того, как промпт достигнет модели.
Контекстные переменные
Контекстные переменные внедряют внешние знания, сохраняя при этом указание на источник. Это позволяет создавать RAG-приложения, в которых LLM отвечают на вопросы, опираясь на ваши конкретные документы.Использование контекстных переменных в RAG-приложениях
Структурированный вывод
Заставьте модели возвращать данные в определённом формате, например в JSON, для программного использования. Настройка выполняется тремя способами:- Визуальный редактор
- JSON Schema
- Генерация ИИ
Удобный интерфейс для простых структур. Добавляйте поля с именами и типами, отмечайте обязательные поля, задавайте описания. Редактор автоматически генерирует JSON Schema.
Память и обработка файлов
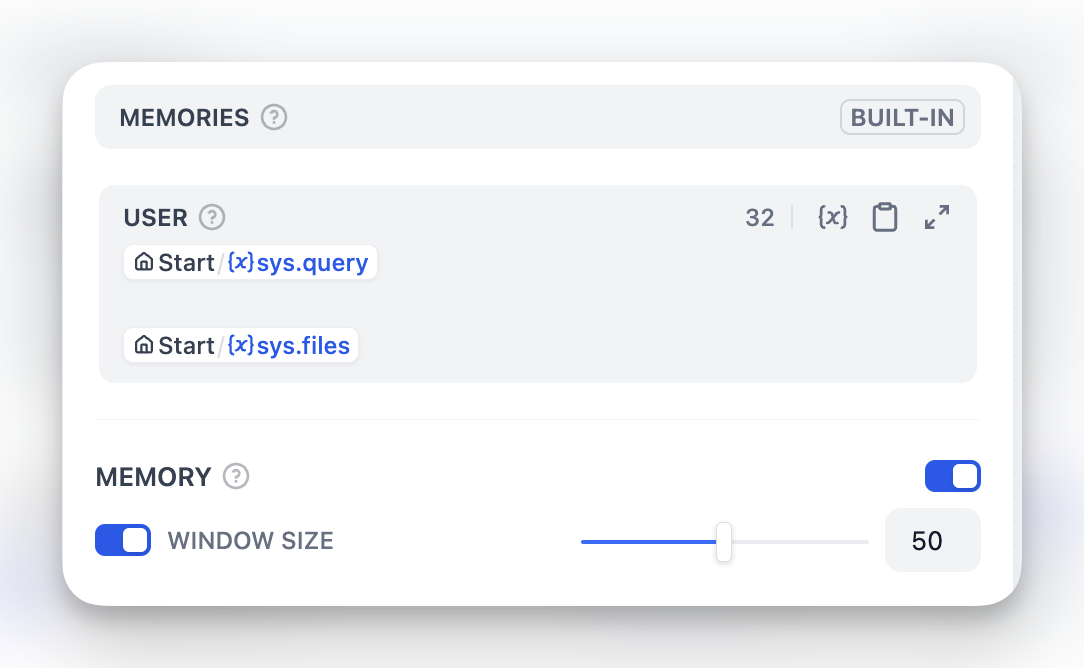
USER. Память привязана к конкретному узлу и не сохраняется между разными разговорами.
Для обработки файлов добавляйте файловые переменные в промпты для мультимодальных моделей. GPT-4V обрабатывает изображения, Claude обрабатывает PDF напрямую, тогда как другим моделям может потребоваться предварительная обработка.
Настройка распознавания изображений
При обработке изображений вы можете управлять уровнем детализации:- Высокая детализация — более высокая точность для сложных изображений, но расходует больше токенов
- Низкая детализация — более быстрая обработка с меньшим числом токенов для простых изображений
userinput.files, который автоматически подхватывает файлы из узла пользовательского ввода.
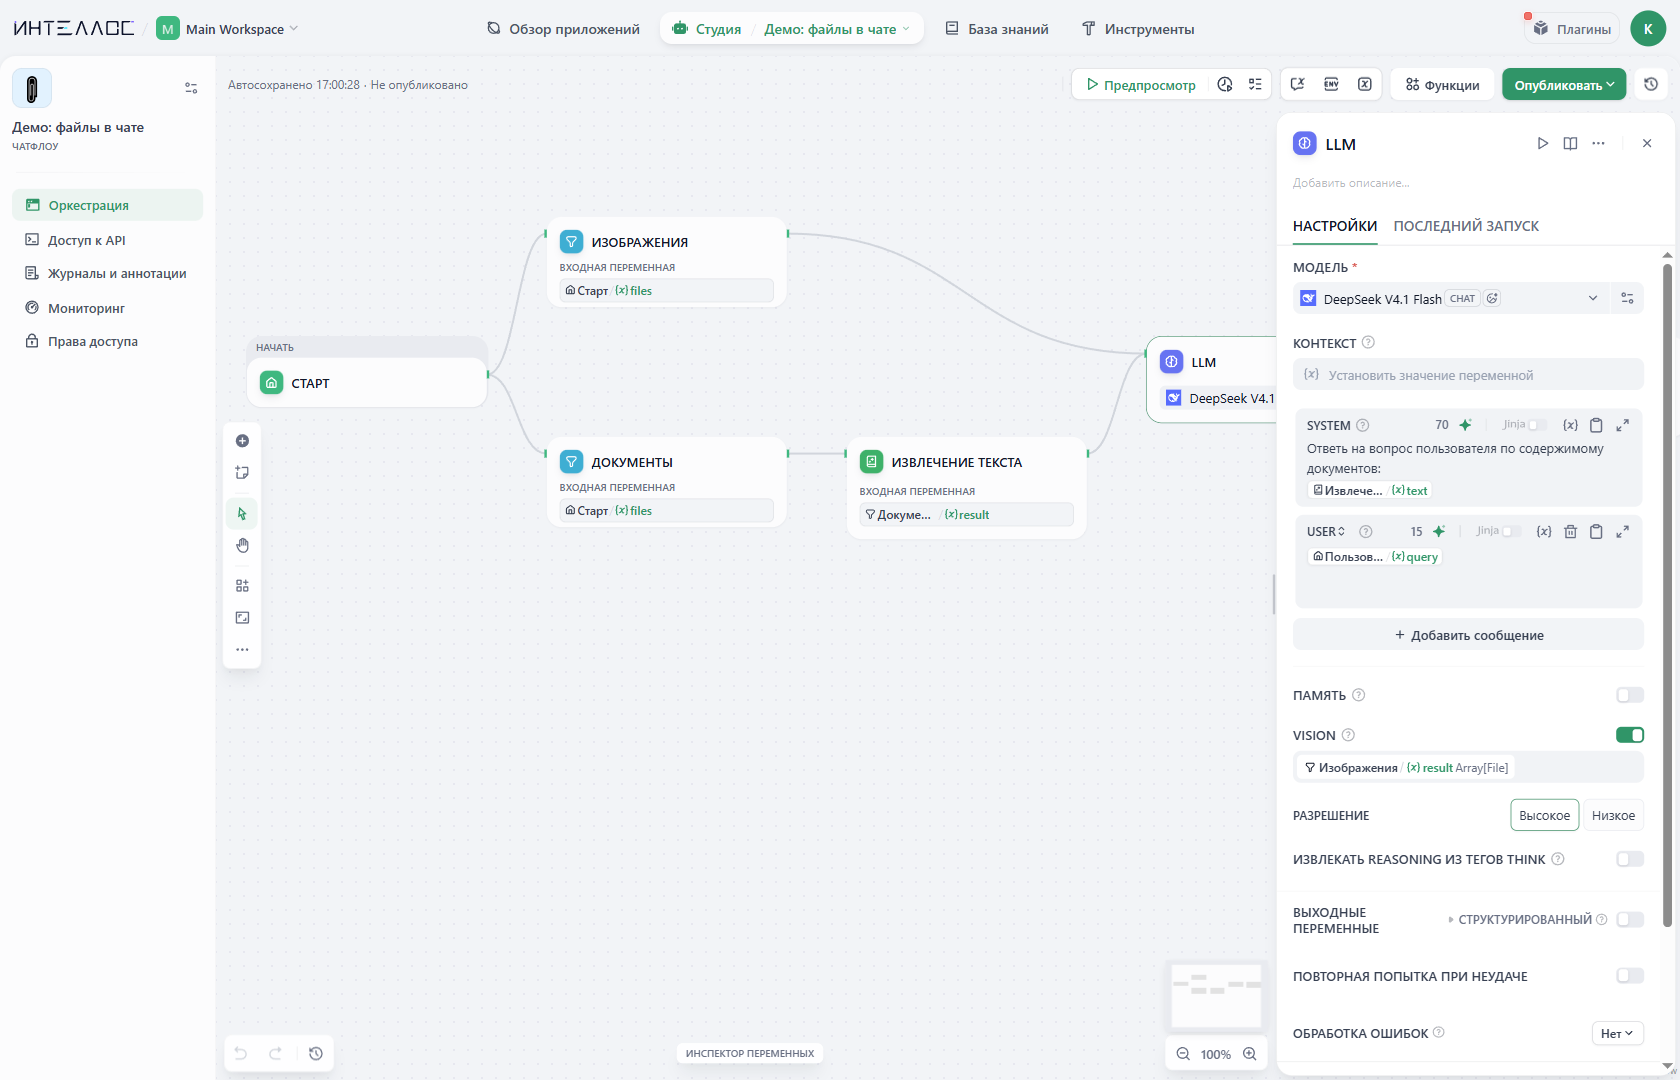
Обработка файлов с помощью мультимодальных LLM
Поддержка шаблонов Jinja2
Промпты LLM поддерживают шаблонизацию Jinja2 для продвинутой работы с переменными. В режиме Jinja2 (edition_type: "jinja2") вы можете:
Потоковый вывод
Узлы LLM по умолчанию поддерживают потоковый вывод. Каждый текстовый чанк передаётся как событиеRunStreamChunkEvent, что позволяет отображать ответ в реальном времени. Файловые выводы (изображения, документы) обрабатываются и сохраняются автоматически во время стриминга.